

Теорія
Стандартизація: z, CV, розмір ефекту і r
Як поставити різні шкали поруч: z-оцінки, коефіцієнт варіації, t як сигнал на шум, d Коена як ефект в одиницях SD і кореляція як коваріація, зведена до проміжку від −1 до 1.
~8 хв читання · 10 вправ · 250 балів
Перед початком
Одна лінійка для різних шкал
Klasna хоче обрати «репетитора семестру», і двоє кандидатів мають різні середні оцінки з різних предметів. Більше число здається переможцем, але репетиторів англійської й математики оцінюють кожних за своєю кривою.
Цей урок завершує модуль 4. Ти поставиш значення з різних шкал на одну лінійку за допомогою z-оцінок, порівняєш розкид через коефіцієнт варіації і познайомишся з розміром ефекту й кореляцією як тією самою ідеєю в іншому вбранні.
z: відстань від середнього в SD
z-оцінка показує, наскільки значення віддалене від середнього своєї групи, у стандартних відхиленнях: z = (x − μ) ÷ σ. Для вибірки бери x̄ і s.
- z = 0: рівно середнє для групи.
- z = +2: на два SD вище середнього.
- z = −1: на один SD нижче.
Суть — у спільній лінійці. «Сирі» числа з різних груп не порівняти: у різних предметах оцінюють по-різному, тести різняться складністю. Ділення на власне SD кожної групи перетворює кожне значення на «наскільки це незвично для своєї групи».
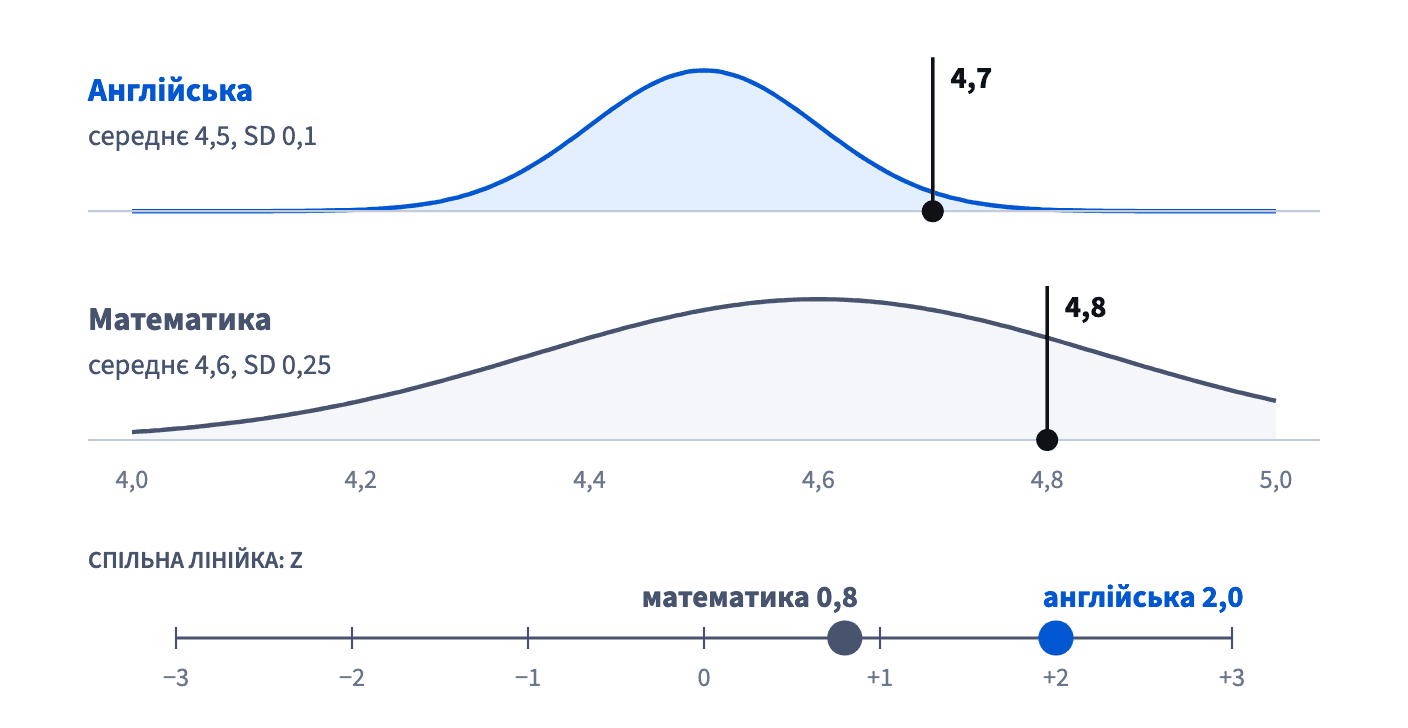
Приклад: репетитори англійської мають у середньому 4,5 з SD 0,1, математики — 4,6 з SD 0,25. Репетиторка англійської з 4,7 має z = (4,7 − 4,5) ÷ 0,1 = 2,0; математик із 4,8 — z = (4,8 − 4,6) ÷ 0,25 = 0,8. Нижча «сира» оцінка виявляється видатнішою.
Пам'ятай порядок дій з уроку Порядок дій, відношення і мультиплікатори: спершу віднімання, потім ділення. Без дужок 4,7 − 4,5 ÷ 0,1 = −40,3 — безглузде число.
- Такz = (78 − 70) ÷ 5 = 1,6: відніми, потім поділи на SD.
- Не так«У математика вища оцінка, тож він виділяється більше.»
«Сирі» оцінки з груп із різними середніми й SD не порівнювані.
Порівняння між групами і пошук викидів
Коли значення переведено в z-оцінки, порівняння між групами стають чесними, а незвичні значення легко помітити.
Формула: x — значення; μ — середнє його групи; σ — SD групи. z рахує, на скільки SD значення вище (+) чи нижче (−) середнього. Для вибірки бери x̄ і s. · є вище
Чесні порівняння. Учень, що набрав 85 у тесті із середнім 80 і SD 10, має z = 0,5. Учень, що набрав 70 у складнішому тесті із середнім 64 і SD 3, має z = 2,0. Другий впорався значно краще відносно своєї групи, попри нижчий «сирий» бал. Так само можна обрати «репетитора семестру» з різних предметів.
Перевірка на викиди. Поширене правило позначає |z| ≥ 3 як підозріле: у даних, схожих на дзвін, значення за три й більше SD від середнього трапляється рідко. Репетитор, у якого середня оцінка має z = −3,2, вартий уваги: це справжня проблема або помилка в даних.
Два застереження. z успадковує все, що є в середньому й SD: один величезний викид роздуває SD і частково ховає сам себе. І z показує позицію, а не надійність: z = 2 серед трьох репетиторів важить набагато менше, ніж серед трьохсот.
- ТакПозначай репетиторів із |z| ≥ 3 для ручної перевірки, перш ніж діяти.
- Не такРанжувати учнів із різних тестів за «сирим» балом.
Спершу переведи кожен бал у z у межах свого тесту.
Коефіцієнт варіації: розкид відносно розміру
SD у 8 уроків на тиждень — величезне для репетитора, що проводить 10 уроків, і мале для того, хто проводить 100. Коефіцієнт варіації зіставляє розкид із розміром: CV = s ÷ x̄, зазвичай у відсотках.
Приклад: репетитори англійської в середньому проводять 40 уроків на тиждень із SD 8, тож CV = 8 ÷ 40 = 20%. Репетитори програмування — 10 уроків із SD 4: CV = 4 ÷ 10 = 40%. У програмування SD менше, але відносно свого розміру воно вдвічі непередбачуваніше.
Одиниці скорочуються, тож CV порівнює величини в різних одиницях: розкид місячних витрат у гривнях і розкид уроків чи хвилин.
Тримай порядок: SD угорі, середнє внизу. Середнє ÷ SD — перевернута версія, і це вже інша ідея, відношення сигналу до шуму. І читай CV як «SD становить п'яту частину середнього», а не як імовірність чи зміну.
- ТакCV = 375 ÷ 1 250 = 30%: витрати коливаються приблизно на 30% від свого середнього.
- Не так«Програмування стабільніше: у нього SD лише 4.»
Відносно середнього 10 SD 4 вдвічі більше, ніж 8 відносно 40.
Коли CV ламається
CV ділить на середнє, тож має сенс лише тоді, коли середнє — змістовна величина: для того, що не буває від'ємним, як-от уроки, гроші, хвилини чи користувачі.
Для чисел, що бувають від'ємними, він ламається. Тижнева зміна бронювань може бути +40 одного тижня і −35 наступного; її середнє може бути +2 із SD 30. Тоді CV = 30 ÷ 2 = 1 500%, і про стабільність це нічого не каже. Якщо середнє зсунеться до −2, CV стане від'ємним; при середньому рівно 0 його взагалі не порахувати. Проблема в знаменнику, а не в даних.
Те саме стосується прибутку, який може стати збитком, температури й будь-якого бала з довільним нулем.
Що робити натомість: подавай саме SD у початкових одиницях («тижнева зміна коливається приблизно на 30 бронювань») або рахуй CV для самого рівня — бронювань на тиждень, які завжди додатні.
- Так«Бронювань на тиждень у середньому 420 із SD 42: CV = 10%.»
- Не так«Тижнева зміна має CV 1 500%, тож вона шалено нестабільна.»
Величезний CV — через середнє біля нуля, а не через нестабільність.
d Коена: ефект в одиницях розкиду
d Коена вимірює ефект відносно того, наскільки різняться люди: d = різниця середніх ÷ s_p, де s_p — об'єднане SD двох груп (об'єднана дисперсія була в уроці Зважене середнє і структура (мікс)).
Приклад: новий формат домашніх завдань підіймає бали тесту на 6, а бали різняться з s_p = 15. d = 6 ÷ 15 = 0,4: чотири десятих SD.
Навіщо ділити? «Сирі» ефекти виміряно в непорівнюваних одиницях. +0,2 бала оцінки й +12 хвилин практики не впорядкуєш як є; в одиницях SD — можна. Тому d корисний, щоб порівнювати тести й планувати їх: що менший d ти хочеш помітити, то більший тест потрібен.
d описує розмір, а не надійність. Він не росте з вибіркою: 100 чи 100 000 користувачів дають приблизно той самий d для того самого ефекту. І не чіпляй до нього сталих ярликів «малий» чи «великий» без контексту: d = 0,1 на дохід може важити більше, ніж 0,5 на метриці, за якою ніхто не діє.
- Такd = 6 ÷ 15 = 0,4: ефект в SD балу.
- Не так«Перемагає тест B: +12 хвилин більше, ніж +0,2 бала.»
Одиниці різні; порівнюй d.
t: сигнал на шум. Подавай t і d разом
Статистики тестів теж стандартизовані. t = різниця ÷ її стандартна похибка: сигнал, виміряний в одиницях шуму. Парна версія вже була в уроці Квадратні корені і √n. t = 3 означає, що різниця на три SE від нуля.
t і d ділять на різне. d ділить на розкид між людьми, s_p, який із більшими даними не зменшується. t ділить на SE, s ÷ √n, яка зменшується. Тож t росте приблизно як √n, навіть коли ефект не змінюється.
Зі 100 000 користувачів у групі приріст d = 0,03 дає t ≈ 0,03 × √50 000 ≈ 6,7: майже напевно справжній і водночас крихітний. Малий пілот може показати протилежне: d = 0,5 із t = 1,2 — можливо, великий ефект, виміряний надто грубо, щоб йому довіряти.
Тож подавай обидва. t, або побудоване з нього p-значення, відповідає на «чи це справжнє?»; d — на «чи це велике?».
- Так«Приріст справжній (t ≈ 6,7), але малий (d = 0,03); запускати, лише якщо це дешево.»
- Не так«t = 6,7 — величезна перемога.»
Великий t від великої вибірки нічого не каже про розмір.
Кореляція r: коваріація на спільній шкалі
Коваріація каже, чи рухаються дві метрики разом: додатна, коли високі значення однієї йдуть із високими значеннями іншої, від'ємна, коли вони рухаються в різні боки. Але її розмір залежить від одиниць: виміряй домашню роботу в хвилинах замість годин, і коваріація зросте в 60 разів.
Ділення на обидва SD прибирає одиниці: r = cov ÷ (s_x · s_y). Результат, коефіцієнт кореляції, завжди лежить між −1 і 1.
Приклад: години домашньої роботи й бали тесту мають cov = 24, s_x = 3 години, s_y = 10 балів. r = 24 ÷ (3 × 10) = 0,8 — сильний додатний зв'язок.
Стеж за добутком у знаменнику: спершу перемнож два SD, потім діли. Якщо рахувати зліва направо, 24 ÷ 3 × 10 = 80 — неможливе r. Якщо колись вийде |r| > 1, помилка десь раніше.
r вимірює лише прямолінійні зв'язки й не каже, що чого причина: більше домашньої роботи й вищі бали можуть обидва йти від вмотивованіших учнів.
- Такr = −18 ÷ (4 × 9) = −0,5.
- Не так«r = 0,8, отже, домашня робота підвищує бали.»
Кореляція показує спільний рух, а не причину.
Як читати r: знак — напрям, |r| — сила
Знак r показує напрям зв'язку, а його розмір без знака, |r|, — силу.
- r біля +1: точки щільно ростуть разом.
- r біля 0: прямолінійного візерунка немає, безформна хмара.
- r біля −1: одне щільно спадає, коли інше росте.
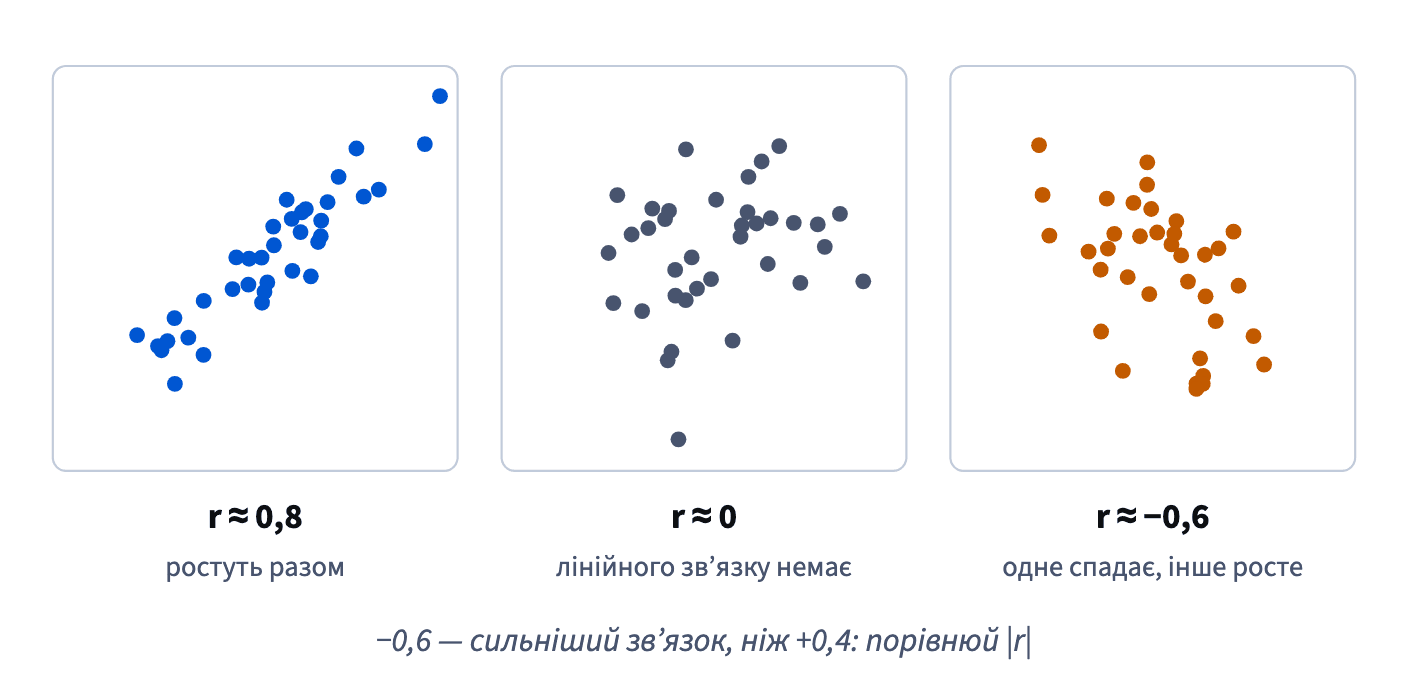
Тож r = −0,72 — сильніший зв'язок, ніж r = 0,60: порівнюй 0,72 із 0,60. Мінус лише каже, що, наприклад, більше днів від останнього уроку йде разом із меншою ймовірністю знову забронювати.
Як це складається докупи: цей модуль збудував розкид із квадратів (дисперсія), коренів (SD і SE) і Піфагора, а цей урок ділить на розкид, щоб звести числа до однієї шкали: z, CV, d, t і r. Модуль 5 переходить до прямих і моделей: що означає нахил і як загальна сума розкладається на частини.
- Так«Дні від останнього уроку й повторне бронювання: r = −0,72, сильний від'ємний зв'язок.»
- Не так«r = 0,60 сильніше за r = −0,72, бо воно додатне.»
Порівнюй |r|; знак — лише напрям.
Готові потренуватися?
Виконайте вправи уроку й отримайте 250 балів, коли пройдете його вперше.
Розпочати вправи