

Теорія
Квадратні корені і √n: SD і стандартна похибка
Стандартне відхилення як √s², стандартна похибка s/√n і чому вчетверо більше даних зменшує її вдвічі, похибка частки, мінімальний помітний ефект, парний t і поправка на скінченну сукупність.
~8 хв читання · 9 вправ · 250 балів
Перед початком
Назад до початкових одиниць
Ти досі в Klasna з дисперсією кількості уроків учнів із минулого разу — у «квадратних уроках». У квадратних уроках ніхто не думає, тож що писати у звіт?
Ти візьмеш квадратний корінь, щоб повернутися до справжніх одиниць, прочитаєш стандартне відхилення як типову відстань від середнього і побачиш, як √n визначає, наскільки можна бути певними щодо середнього.
Стандартне відхилення: назад до справжніх одиниць
Дисперсію вимірюють у квадратних одиницях: дисперсія п'ятьох учнів 14,5 з уроку Навіщо квадрат — це «уроки в квадраті», яких ніхто не уявить. Стандартне відхилення добуває квадратний корінь і повертає одиницю: s = √s² = √14,5 ≈ 3,81 уроку. Уяви дисперсію як площу квадрата; SD — його сторона.
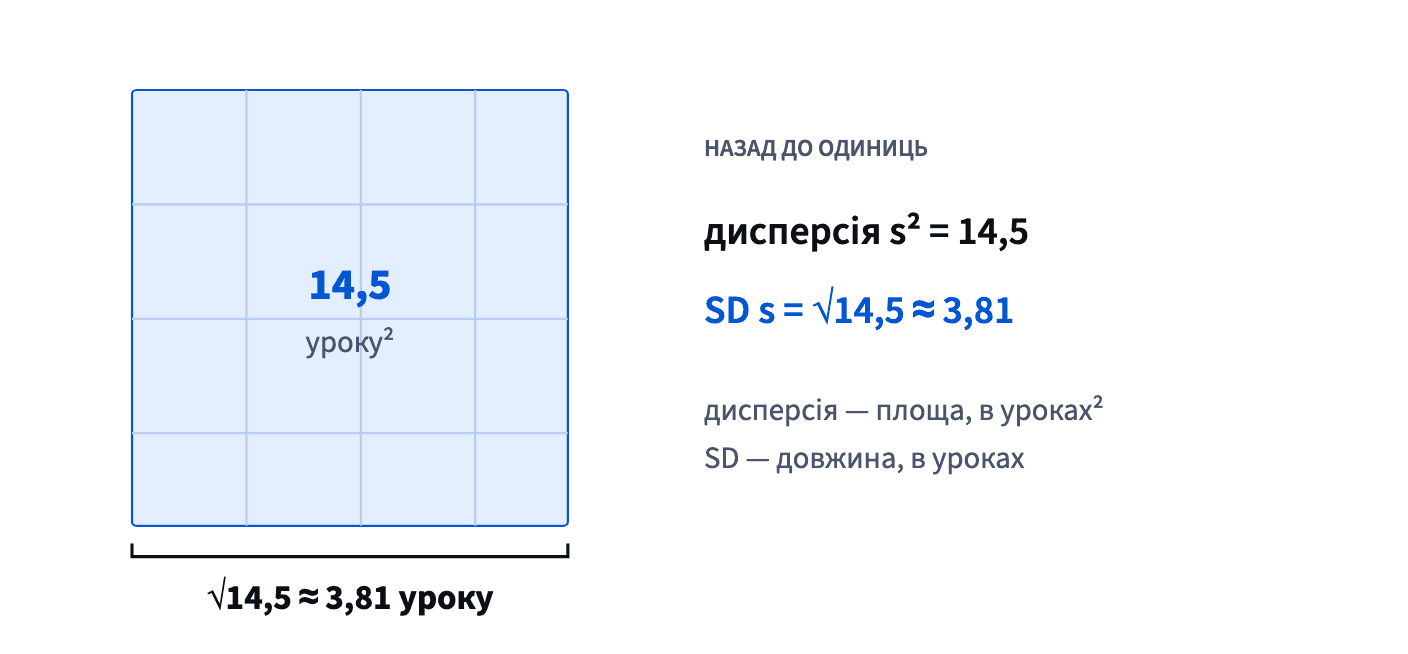
Читай SD як типову відстань значення від середнього. Якщо середнє — 8 уроків, а s ≈ 3,8, більшість учнів — у межах приблизно чотирьох уроків від 8 в обидва боки. Для генеральної сукупності так само: σ = √σ².
Дві перевірки тримають арифметику чесною. Піднеси відповідь до квадрата — має вийти дисперсія: 3,81 × 3,81 ≈ 14,5. І SD ніколи не буває від'ємним чи більшим за весь розмах даних.
У таблиці STDEV.S — це корінь із VAR.S, а STDEV.P — корінь із VAR.P.
- Так«Учні в середньому взяли 8 уроків, SD 3,8 уроку.»
- Не так«Розкид — 14,5 уроку.»
14,5 — це дисперсія в уроках у квадраті; розкид в уроках — корінь із неї.
SD чи SE: люди чи середнє
Стандартне відхилення і стандартна похибка відповідають на різні питання, і плутанина між ними — одна з найчастіших помилок у звітах.
- SD: наскільки різняться окремі значення. «8 ± 3,81 уроку» — чесний опис п'ятьох учнів: типовий учень — приблизно за 4 уроки від середнього.
- SE: наскільки коливалося б середнє вибірки, якби взяти іншу вибірку того самого розміру. Для n > 1 вона завжди менша за SD і зменшується зі зростанням вибірки; SD — ні.
Тож «середнє ± SD» описує, як розкидані люди, і це не довірчий інтервал. Прочитати 8 ± 3,81 як «справжнє середнє між 4,2 і 11,8» — означає змішати одне з другим: цей діапазон показує, де типові учні, а не де середнє. Інтервал для середнього будують із SE (як — покаже модуль 7).
У звіті завжди пиши, що саме показано: «SD 3,8» чи «SE 1,7», а не голе «± 3,8».
- Так«Середнє 8 уроків (SD 3,8, n = 5).»
- Не так«Ми на 95% певні, що середнє — 8 ± 3,81.»
Цей діапазон побудовано з SD, тож про середнє він нічого не каже.
Стандартна похибка: SE = s ÷ √n
Середнє вибірки — теж випадкове число: візьми інших п'ятьох учнів, і середнє буде іншим. Стандартна похибка вимірює, наскільки воно коливалося б: SE = s ÷ √n.
Чому √n, а не n? Випадкові похибки частково компенсуються: одні значення вище середнього, інші нижче. Ця компенсація росте як квадратний корінь із розміру вибірки, а не як сам розмір. Для п'ятьох учнів s = 3,81 і √5 ≈ 2,24, тож SE ≈ 1,70 уроку. Для 20 учнів із тим самим розкидом √20 ≈ 4,47 і SE ≈ 0,85.
Зверни увагу, що змінюється, а що ні. Більше даних майже не змінює SD (учні не стають схожішими), але SE і далі падає.
Порядок дій: спершу √n, потім ділення. Оцінки з s = 15 балів, усереднені по n = 25, дають SE = 15 ÷ 5 = 3 бали: окремі оцінки різняться приблизно на 15, а їхнє середнє — приблизно на 3.
- ТакSE = 15 ÷ √25 = 15 ÷ 5 = 3.
- Не такSE = 15 ÷ 25 = 0,6.
Ділимо на √n, а не на n.
Учетверо більше даних — удвічі менша похибка
Оскільки SE = s ÷ √n, похибка падає як квадратний корінь із розміру вибірки, тож кожна наступна порція даних дає дедалі менше.
- Учетверо більше даних → √4 = 2 → похибка вдвічі менша.
- Усоте більше даних → √100 = 10 → похибка вдесятеро менша.
- Удвічі більше даних → √2 ≈ 1,41 → похибка менша лише приблизно на 29%.
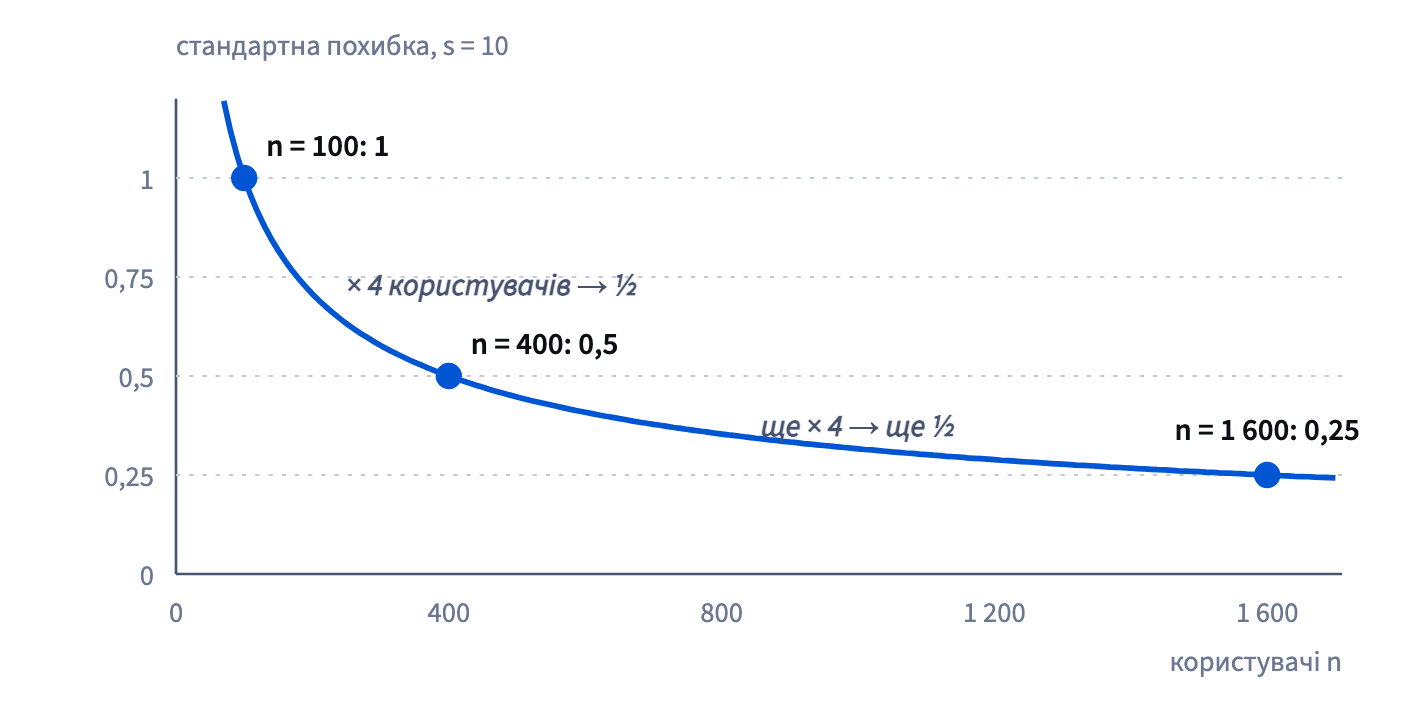
Для s = 10: при n = 100 SE = 1,0, при n = 400 — 0,5, при n = 1 600 — 0,25. Кожне зменшення вдвічі коштує вчетверо більше користувачів, ніж попередній крок. Перша сотня користувачів дає багато, кожна наступна партія — менше.
Ілюстрація: Більше даних допомагає, але щораз менше. · є вище
Ось арифметика за кожним «а може, просто потримаємо тест трохи довше?». Подвоєння тривалості тесту не зменшує похибку вдвічі: його треба подовжити вчетверо. Це працює й навпаки: чверть даних подвоює похибку.
- Так«Щоб зменшити похибку вдвічі, потрібно вчетверо більше користувачів, тож тест іде чотири тижні, а не два.»
- Не так«Удвічі більше трафіку — удвічі менша похибка.»
Удвічі більше трафіку ділить похибку на √2 ≈ 1,41.
Стандартна похибка частки
Для частки, наприклад конверсії, окремого s немає: розкид випливає з самого p. Результат «так/ні» з часткою p має дисперсію p(1 − p), тож
SE_p = √(p(1 − p) ÷ n).
Приклад: конверсія 5%, виміряна на n = 1 900 користувачах. p(1 − p) = 0,05 × 0,95 = 0,0475. Ділимо на 1 900: 0,000025. Корінь: 0,005, тобто 0,5 відсоткового пункту.
Три звички, щоб не помилитися:
- у формулу пиши p десятковим дробом (0,05, а не 5), а результат переводь у відсоткові пункти наприкінці;
- ділиш на n до того, як добувати корінь, а не після;
- пам'ятай, що p(1 − p) найбільше при p = 0,5, тож частки близько 50% найшумніші (до цього повертається урок p і 1 − p у модулі 7).
Читай результат у відсоткових пунктах: SE 0,005 для конверсії 5% — це 0,5 в. п., а не 0,5%.
- Так√(0,05 × 0,95 ÷ 1 900) = 0,005 = 0,5 в. п.
- Не так√(0,05 × 0,95) ÷ 1 900 ≈ 0,0001.
n має бути під коренем; ділення після кореня робить похибку в 44 рази замалою.
MDE іде за стандартною похибкою
Мінімальний помітний ефект (MDE) — найменший справжній приріст, який тест може надійно помітити. За звичних налаштувань це приблизно 2,8 стандартної похибки: MDE ≈ 2,8 × SE. Звідки 2,8, розповідає модуль 7; тут ми просто цим користуємося.
Оскільки MDE — фіксоване кратне SE, він успадковує правило √n. Скажімо, 1 500 користувачів у групі дають MDE 3 в. п. Тоді:
- 6 000 у групі (учетверо більше) дають 1,5 в. п.;
- 3 000 у групі (удвічі більше) дають приблизно 3 ÷ 1,41 ≈ 2,1 в. п., а не 1,5 в. п.;
- 375 у групі (чверть) дають 6 в. п.
Зменшити шуканий ефект удвічі — значить збільшити вибірку вчетверо. Тому «пошукаймо менший приріст» — дороге речення. Спершу виріши, який найменший приріст вартий дій, а потім рахуй розмір тесту під нього, а не навпаки.
- Так«Щоб побачити вдвічі менший ефект, потрібно вчетверо більше користувачів у групі.»
- Не так«Подвоїмо групи — і помітимо вдвічі менший приріст.»
Подвоєння n зменшує MDE лише в √2 ≈ 1,41 раза.
Парні тести: та сама ідея на різницях
Коли тих самих людей вимірюють двічі — до й після навчання чи минулого й цього місяця, — кожного порівнюють із самим собою. Працюють із різницями d = після − до, і правило √n застосовують до них:
- d̄ — середня різниця;
- s_d — стандартне відхилення різниць;
- SE = s_d ÷ √n;
- парний t = d̄ ÷ SE: на скільки стандартних похибок середня зміна віддалена від нуля.
Приклад: 16 репетиторів Klasna оцінили до й після навчання. Середня зміна d̄ = 0,3 бала, s_d = 0,4. SE = 0,4 ÷ √16 = 0,1, тож t = 0,3 ÷ 0,1 = 3: зміна на три стандартні похибки від нуля, і списати її на випадок важко.
Головна похибка — взяти розкид самих оцінок замість розкиду різниць. Парування прибирає відмінності між репетиторами, тож s_d зазвичай значно менше, і саме в цьому сенс парування.
- ТакСпершу порахуй зміну для кожного репетитора, потім d̄ і s_d цих змін.
- Не такДілити середню зміну на SD усіх оцінок «до».
Так парування ігнорується, і справжні ефекти ховаються.
Великі вибірки з малих сукупностей
Формула s ÷ √n припускає, що сукупність величезна порівняно з вибіркою. Коли вибірка — велика частина малої сукупності, невизначеності менше, і SE зменшує поправка на скінченну сукупність: √((N − n) ÷ (N − 1)).
Опитування 400 із 1 120 учнів Klasna: √(720 ÷ 1 119) = √0,643 ≈ 0,80, тож SE на 20% менша, ніж каже звичайна формула. Якщо опитати 400 з мільйона, множник майже 1, і його можна не брати до уваги. Поширене практичне правило: зважай на поправку, лише коли вибірка більша приблизно за 5% сукупності.
Як це складається докупи: квадратний корінь перетворює дисперсію на SD; ділення на √n перетворює SD на стандартну похибку середнього чи частки; MDE і парний t побудовано на цій SE. Наступний урок покаже, як похибки й відстані додаються через квадрати.
- Так400 із 1 120 учнів: помнож SE на √(720 ÷ 1 119) ≈ 0,80.
- Не такЗастосовувати поправку до вибірки 400 з мільйона користувачів.
Множник майже 1, він нічого не змінює.
Готові потренуватися?
Виконайте вправи уроку й отримайте 250 балів, коли пройдете його вперше.
Розпочати вправи