

Теорія
p і 1 − p
Імовірність як частка, доповнення 1 − p, утримання як 1 − відтік і чому p(1 − p) найбільше при 0,5.
~8 хв читання · 9 вправ · 250 балів
Перед початком
Наскільки це ймовірно і наскільки ми певні?
Klasna — онлайн-школа репетиторів, чиї числа ти перевіряєш, — живе наслідками «так чи ні»: учень після пробного уроку купує або ні, учасник Club лишається або скасовує, результат тесту справжній або випадковий.
Цей модуль перетворює такі наслідки на ймовірності й питає, наскільки їм можна довіряти: умовна ймовірність, математичне сподівання, багато тестів одразу, нормальна крива і статистична потужність. Перший урок починає з найпростішої пари: імовірність p, її доповнення 1 − p і їхній добуток p(1 − p), що стоїть у кожній стандартній похибці частки.
Імовірність — це частка
Імовірність — це частка випадків, у яких щось стається, серед багатьох схожих випадків. Порахуй випадки, де подія сталася, і поділи на всі випадки: p = випадки з подією ÷ усі випадки. Тому будь-яка ймовірність лежить між 0 (ніколи) і 1 (завжди) і її можна записати у відсотках: 0,24 = 24%.
У вересні 400 людей узяли безкоштовний пробний урок у Klasna, і 120 потім купили пакет: p = 120 ÷ 400 = 0,30. Про наступного учня «так» чи «ні» сказати неможливо, але можна сказати «0,30»: серед довгого ряду схожих учнів купують приблизно 30 зі 100.
Дві звички тримають число чесним. Угорі — випадки, які рахуєш, унизу — усі випадки; «імовірність» понад 1 означає, що дріб перевернуто. І читай p як частку на довгій дистанції, а не як обіцянку про одну людину чи про точну кількість у наступній невеликій групі.
- Так«Пакет купують близько 30% учнів після пробного уроку: 120 із 400 у вересні.»
Частка серед багатьох схожих випадків, із кількостями за нею.
- Не так«Цей учень купить з імовірністю 120.»
Кількість — не ймовірність; поділи на всі випадки.
Доповнення: 1 − p
Доповнення події — це все, що не є цією подією: для «учень після пробного уроку купує» це «учень не купує». Разом вони охоплюють усі випадки й ніколи не перетинаються, тож їхні ймовірності дають рівно 1: P(не A) = 1 − P(A).
У Klasna пакет купують 0,30 учнів після пробного уроку, отже, 1 − 0,30 = 0,70 не купують. Якщо 97% уроків починаються вчасно, то 3% починаються із запізненням або не відбуваються. Зверни увагу на другу частину: «із запізненням або не відбуваються». Доповнення збирає всі інші наслідки, а не лише найочевидніший.
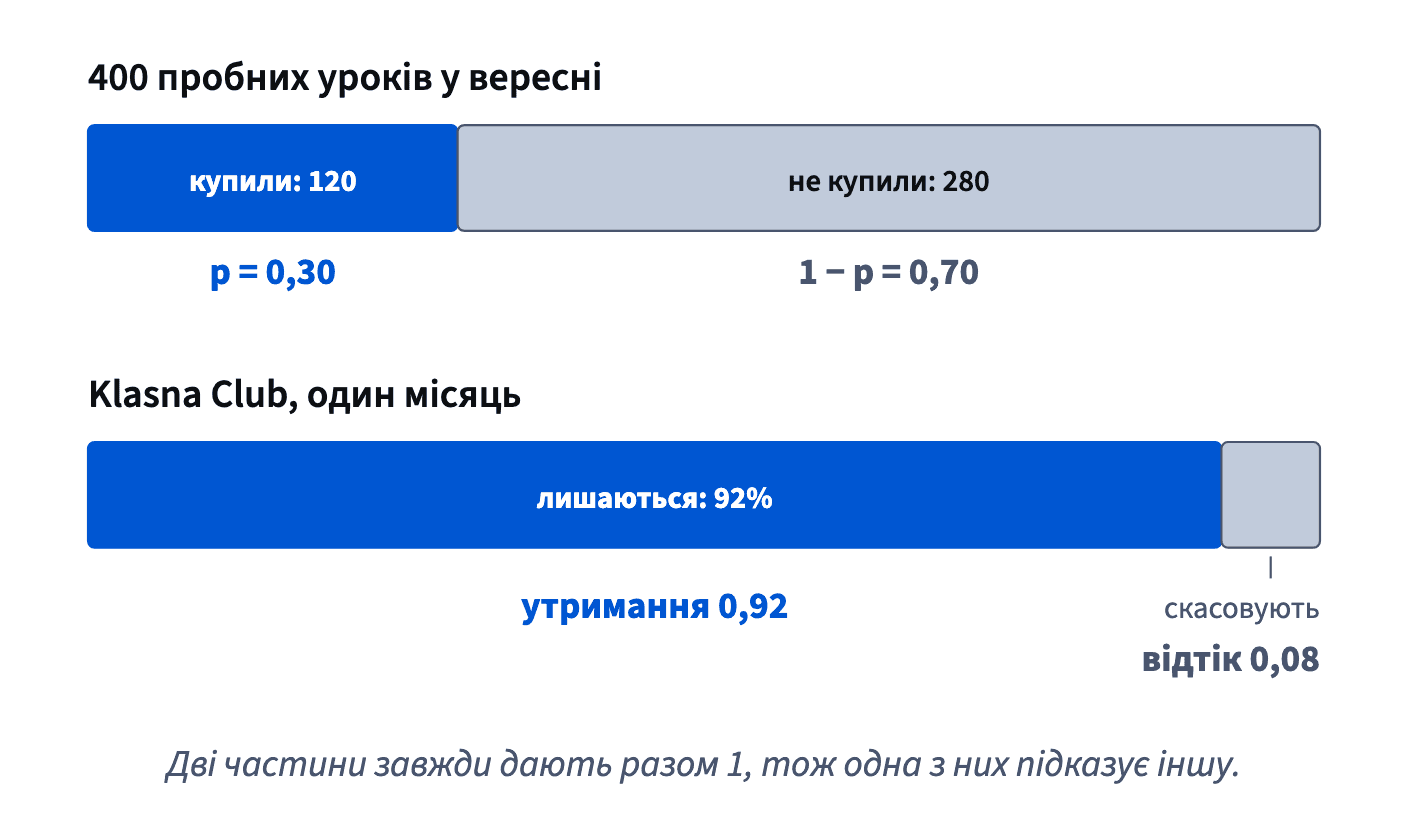
Навіщо вчити таке просте правило? Бо одну сторону часто значно легше виміряти чи назвати, ніж іншу. Звіт, що дає одну частку, непомітно дає й другу, а ймовірність, яку важко порахувати напряму, часто знаходять як 1 мінус її доповнення.
- Так«Пакет купують 30% учнів після пробного уроку, отже, 70% ідуть без нього.»
- Не так«3% уроків починаються із запізненням», хоча ці 3% включають і уроки, яких не було.
Доповнення до «вчасно» — «із запізненням або не відбувся»; назви його повністю.
Дві перевірки, перш ніж писати 1 − p
Правило P(не A) = 1 − P(A) працює лише тоді, коли «не A» вибрано правильно. Спершу перевір дві речі.
Охоплено всі випадки. «Купує пакет» і «купує окремий урок» не перетинаються, але й не охоплюють усіх: дехто після пробного уроку не купує нічого. Якщо пакет купують 30%, а окремий урок — 25%, разом це 0,55, а доповнення до «купує пакет» — «окремий урок або нічого», 0,70.
Жоден випадок не пораховано двічі. «Був на розмовному клубі» і «користувався AI-партнером» можуть бути правдою для того самого учасника Club, тож 1 мінус одне з них нічого не каже про інше.
Коли обидві перевірки пройдено, доповнення — це скорочений шлях. «Пропустив хоча б один урок цього місяця» рахувати незручно: один пропуск, два, три… Його доповнення, «не пропустив жодного», — одне число, а 1 мінус воно дає все інше.
- Так«У травні 85% учнів були на всіх уроках, отже, 15% пропустили хоча б один.»
Одне чисте доповнення замість підрахунку одного, двох, трьох пропусків.
- Не так«25% купили окремий урок, отже, 75% купили пакет.»
Забуто всіх, хто нічого не купив.
Утримання — це 1 − відтік
Підписки дають найпоширеніше доповнення в продуктовій роботі. Відтік — частка учасників, які скасовують підписку за період; утримання — частка тих, хто лишається. Кожен учасник робить або одне, або інше, тож утримання = 1 − відтік.
Klasna Club у звичайний місяць утрачає 8% учасників, отже, утримання — 1 − 0,08 = 0,92, або 92%. У березні відтік становив 6,5%, тож утримання було 100 − 6,5 = 93,5%. У відсотках віднімай від 100, у частках — від 1. Не змішуй: 1 − 6,5 не означає нічого.
Звідси два наслідки. Звіт, де є лише відтік, уже показує й утримання, тож однієї колонки досить. А коли формулі потрібна частка, що доживає до кінця місяця, як у Складних відсотках, де рік із місячним відтоком 8% зберігає 0,92¹² ≈ 0,37 учасників, вона хоче 1 − відтік, а не сам відтік.
- Так«Місячний відтік 6,5%, отже, місячне утримання 93,5%.»
- Не так«Утримання = 1 − 6,5 = −5,5.»
Змішано відсоток і частку; бери 100 − 6,5 або 1 − 0,065.
p(1 − p): наскільки важко вгадати наступну відповідь
Познач кожного учня після пробного уроку як 1, якщо купив, і 0, якщо ні. Розкид цих нулів і одиниць, їхня дисперсія з уроку Навіщо квадрат, виходить рівно p(1 − p). Вона показує, наскільки непередбачуваний наслідок «так/ні».
Спробуй кілька значень: p = 0,1 дає 0,1 × 0,9 = 0,09; 0,3 дає 0,21; 0,5 дає 0,25; далі знову спадає: 0,7 дає 0,21, а 0,9 — 0,09. Видно дві закономірності: пік при 0,5, а якщо поміняти p і 1 − p місцями, нічого не зміниться.
Чому так, пояснює малюнок. p(1 − p) — площа прямокутника зі сторонами p і 1 − p. Сторони разом завжди дають 1, а з усіх таких прямокутників найбільшу площу має квадрат.
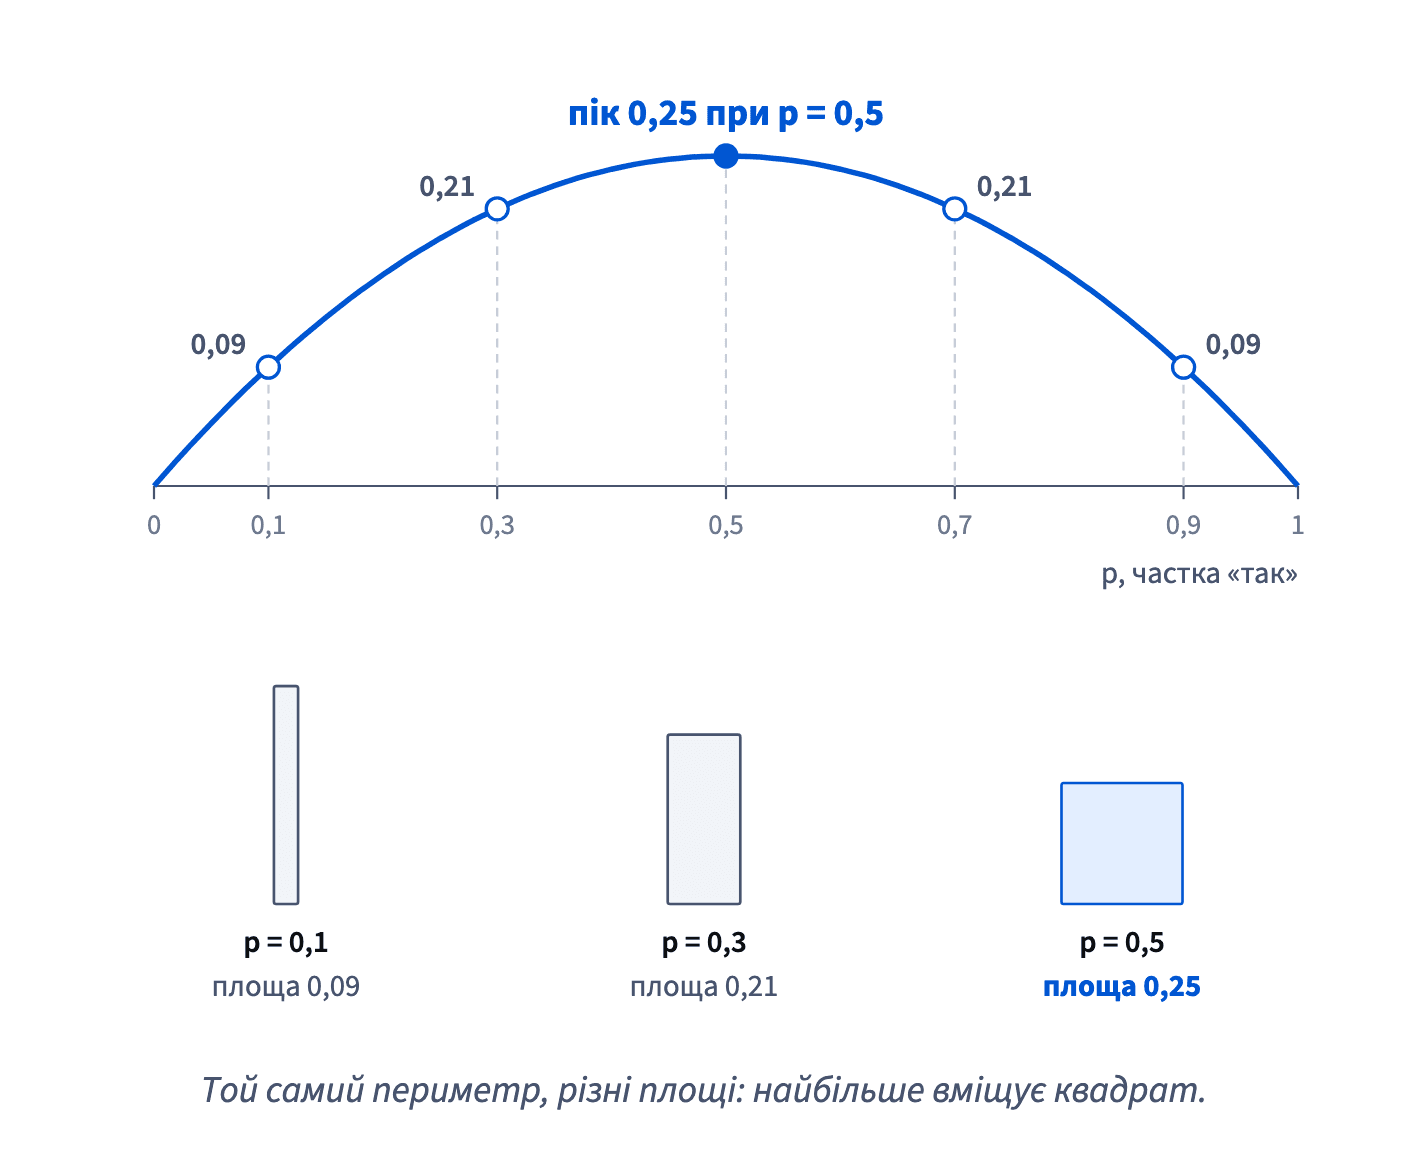
При 0,5 наступна відповідь — як підкидання монети; при 0,02 ти скажеш «ні» і майже завжди вгадаєш. Тож серед кроків воронки, виміряних на однаковій кількості людей, найбільше p(1 − p) у того, що найближчий до 0,5.
- Так«Конверсія 0,45 — біля середини, тож цей крок майже максимально непередбачуваний.»
- Не так«Що вища конверсія, то більше p(1 − p).»
Воно росте лише до 0,5, а далі дзеркально спадає.
p(1 − p) у формулах розміру вибірки
p(1 − p) з’являється скрізь, де формула вимірює шум частки. Формула розміру вибірки для A/B-тесту конверсії додає його для обох варіантів: p₁(1 − p₁) + p₂(1 − p₂). Що шумніший наслідок, то більше людей потрібно тесту.
Рахують це у два кроки: спершу доповнення, потім добуток. Для базової конверсії 4%: 1 − 0,04 = 0,96, і 0,04 × 0,96 = 0,0384. Для другого варіанта з 5%: 0,05 × 0,95 = 0,0475. Разом 0,0859.
Подивися, що відбувається з рідкісними подіями. Коли p мале, 1 − p майже 1, тож p(1 − p) майже дорівнює самому p: 0,0384 проти 0,04. Це швидка перевірка на здоровий глузд. Для конверсій у кілька відсотків p(1 − p) має виходити трохи меншим за p. Результат більший за p чи близький до 0,25 зазвичай означає, що замість частки підставили відсоток: 4 замість 0,04.
- Такp₁ = 0,04 → p₁(1 − p₁) = 0,04 × 0,96 = 0,0384, трохи менше за 0,04.
- Не такp₁(1 − p₁) = 4 × 96 = 384.
Відсотки замість часток; бери 0,04 і 0,96.
Стандартна похибка частки
Стандартна похибка частки з уроку Квадратні корені і √n — це SE = √(p(1 − p) ÷ n): шум одного наслідку «так/ні», p(1 − p), розподілений на n людей, а потім узятий під корінь, щоб повернутися до одиниць частки.
Для пробних уроків Klasna p = 0,30 і n = 400: √(0,21 ÷ 400) = √0,000525 ≈ 0,023. Тож 30% відомі з точністю приблизно ±2,3 відсоткового пункту на одну стандартну похибку.
Оскільки p(1 − p) симетричне, симетрична й стандартна похибка. Частка 20% і частка 80%, виміряні на однаковій кількості людей, мають рівно ту саму SE, бо 0,2 × 0,8 = 0,8 × 0,2 = 0,16. Якщо написати «80% задоволені» замість «20% незадоволені», зміниться заголовок, а не точність.
Що справді змінює SE, то це близькість p до 0,5 і кількість виміряних людей. Частку біля 0 чи 1 визначають точно з меншою кількістю людей, ніж частку посередині.
- Так«Купили 30%, ± приблизно 2,3 в. п. на одну стандартну похибку (n = 400).»
- Не так«80% задоволених — точніше число, ніж 20% незадоволених.»
Те саме n, те саме p(1 − p) = 0,16, та сама SE.
Частка невідома? Плануй з 0,5
Перед опитуванням чи тестом частка, яку треба виміряти, невідома, а формулі стандартної похибки потрібне p. Бери p = 0,5. Воно дає найбільше p(1 − p), 0,25, а отже, найбільшу SE для твого n — найгірший випадок.
Формула: p — спостережена частка; n — на скількох людях її виміряно. · є вище
Для 625 батьків: √(0,25 ÷ 625) = 0,5 ÷ 25 = 0,02, тобто 2 відсоткові пункти. Якщо справжня частка виявиться 20%, p(1 − p) = 0,16, і SE зменшиться до √(0,16 ÷ 625) = 0,016. Хай яка буде відповідь, точність може бути лише кращою за заплановану.
Ризикована саме низька оцінка. Заплануй з 10%, отримай справжню частку близько 50% — і похибка буде більшою, ніж розрахована вибірка.
Як це складається докупи: імовірність — це частка; її доповнення — 1 − p; їхній добуток p(1 − p) — шум наслідку «так/ні», найбільший при 0,5. Наступний урок додає умову: імовірність A за умови B і таблицю 2×2, на якій тримаються precision і recall.
- Так«Частки ще не знаємо, тож розмір опитування рахуємо для p = 0,5.»
- Не так«Точно мало хто скаже «так», тож плануємо з 10%.»
Якщо оцінка хибна, вибірка замала.
Готові потренуватися?
Виконайте вправи уроку й отримайте 250 балів, коли пройдете його вперше.
Розпочати вправи