

Теорія
Інші криві й потужність
t, хі-квадрат і F як та сама ідея з іншою таблицею, ступені свободи, очікувані частоти й Σ(O − E)²/E і як порахувати потужність тесту.
~8 хв читання · 10 вправ · 250 балів
Перед початком
Та сама ідея, інша таблиця
Останній урок модуля про ймовірність, і досі на числах Klasna. У курсі статистики на тебе чекають t-тести, тести хі-квадрат і ANOVA. Вони здаються трьома новими темами, але це одна ідея з трьома таблицями.
Ти побачиш, як кожен тест перетворює дані на одну статистику й порівнює її з власною кривою та критичним значенням, а потім — як потужність тесту показує, чи був він достатньо великим, щоб помітити справжній ефект.
Одна ідея, кілька таблиць: статистика проти критичного значення
t-тести, тести хі-квадрат і ANOVA схожі на три окремі предмети. Насправді це одна ідея з різними таблицями.
Кожен тест стискає дані в одне число — статистику: приблизно сигнал ÷ шум. Далі питає, наскільки далеко в хвіст своєї кривої це число потрапляє. Точка, за якою лишається 5%, — критичне значення; статистику за нею вважають значущою на рівні 5%.
Криві різні, тож різні й межі: 1,96 для z, 2,101 для t з 18 ступенями свободи, 3,84 для хі-квадрат з 1, 3,10 для F з (3, 20). Їх не рахують, а беруть із таблиці чи таблиці-калькулятора.
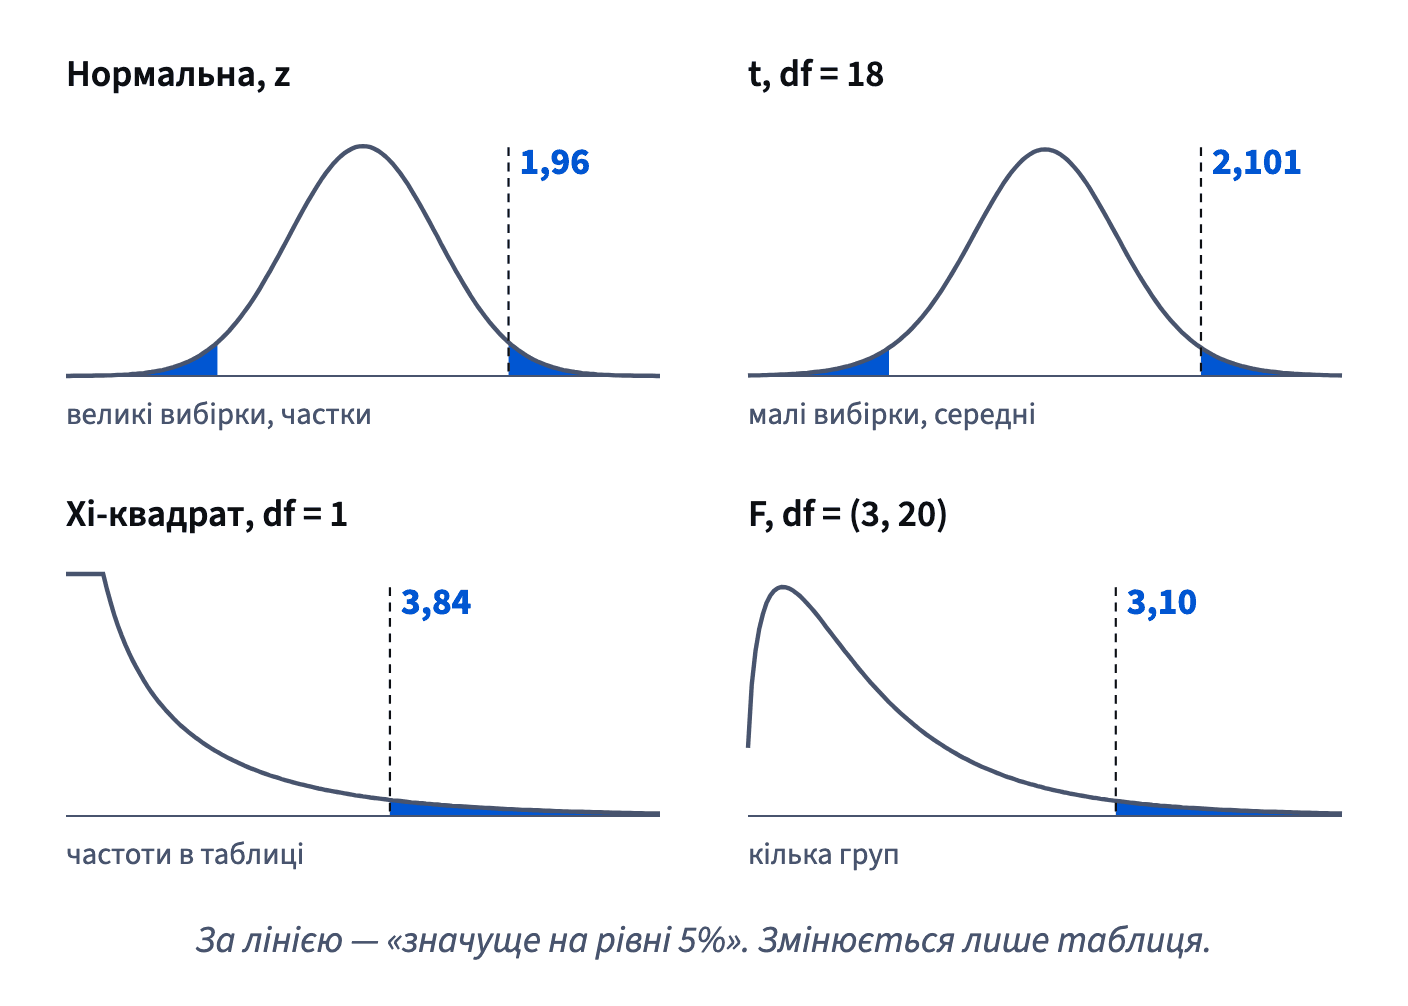
Класична помилка — брати 1,96 від z для всього. t = 2,05 для двох груп по 10 долає 1,96, але не 2,101, тож на рівні 5% результат не значущий.
- Так«t = 2,05 з 18 df, критичне значення 2,101: на рівні 5% не значуще.»
- Не так«t = 2,05 > 1,96, отже, новий метод репетиторів працює.»
Межу z застосовано до статистики t.
Яка крива до якого тесту
Запитання визначає статистику, а статистика — свою криву.
- Порівнюємо середні двох малих груп, скажімо по 10 учнів: статистика t, її криву задають n₁ + n₂ − 2 = 18 ступенів свободи, критичне значення 2,101.
- Таблиця частот, як-от записався чи ні з нагадуванням і без: хі-квадрат, з (рядки − 1)(стовпці − 1) = 1 ступенем свободи для таблиці 2×2, критичне значення 3,84.
- Середні кількох груп, скажімо чотири групи по 6: F із двома числами ступенів свободи, (групи − 1, люди − групи) = (3, 20), критичне значення 3,10.
- Частки у двох великих групах: z, критичне значення 1,96.
Кожна пара — той самий хід: порахувати статистику, знайти критичне значення для її кривої та ступенів свободи, порівняти.
- Так«Записався чи ні, з нагадуванням чи без: таблиця 2×2, отже, хі-квадрат з 1 df.»
- Не так«Чотири групи репетиторів порівняно одним t-тестом.»
Для кількох груп потрібен F (або набір пар із поправкою).
Ступені свободи вибирають криву
Ступені свободи (df) показують, скільки приблизно незалежної інформації лишається після того, як статистика частину її використала. Вони вибирають, яку криву з родини читати.
Кожна оцінка з даних забирає один ступінь. t-тест для двох груп оцінює два середні, тож df = n₁ + n₂ − 2: для 12 і 15 учнів це 12 + 15 − 2 = 25. Таблиця з r рядків і c стовпців має (r − 1)(c − 1): коли підсумки рядків і стовпців зафіксовано, вільно змінюватися можуть лише стільки клітинок. F для k груп і N людей має два числа: (k − 1, N − k).
Найбільше це важить для малих вибірок. Із малою кількістю ступенів свободи крива має важчі хвости й вищу межу; з великою — заспокоюється. Помилка в df означає читати не той рядок таблиці.
- Так«12 і 15 учнів: df = 12 + 15 − 2 = 25.»
- Не так«12 і 15 учнів: df = 27, тобто кількість людей.»
Середнє кожної групи забирає один ступінь свободи.
Малі вибірки — важчі хвости
Крива t схожа на нормальну, але має важчі хвости. У малій вибірці сам шум оцінюють за невеликою кількістю людей, тож крайні значення статистики випадково трапляються частіше. Щоб частка хибних тривог лишалася 5%, межа відсувається: 2,228 для 10 ступенів свободи, 2,101 для 18.
Зі зростанням вибірки оцінка шуму стабілізується, а хвости тоншають. Для 30 ступенів свободи межа — 2,042; для 100 — близько 1,98, майже 1,96 для z. Для великих вибірок t і z дають практично той самий вердикт.
Тож таблиця t важлива для малих груп, як-от пілот із десятком учнів у кожній групі, і майже не важить для продуктових тестів із тисячами користувачів. Якщо взяти 1,96 для малої вибірки, тест виглядатиме переконливішим, ніж є.
- Так«Пілот із 10 учнями в групі: порівнюємо t з 2,101, а не з 1,96.»
- Не так«5 000 користувачів на варіант, тож потрібна спеціальна таблиця t.»
За такого розміру t і z збігаються.
Очікувані частоти: що передбачає «різниці немає»
Тест хі-квадрат порівнює таблицю спостережених частот із частотами, яких можна було б очікувати, якби групи не відрізнялися. Перший крок — ці очікувані частоти.
Якби група нічого не змінювала, кожна група мала б загальну частку. Дзвінок Klasna про цілі: з ним купили 105 із 300, без нього — 125 із 500, загалом 230 із 800 = 28,75%. Тож від 300 учнів із дзвінком очікували б 300 × 0,2875 = 86,25 покупця.
Як одне правило: E = підсумок рядка × підсумок стовпця ÷ загальний підсумок. Для дзвінка: 300 × 230 ÷ 800 = 86,25. Для учасників Club, які в перший тиждень прийшли на розмовний клуб: прийшли 200, скасували 180 з усіх 800, тож E = 200 × 180 ÷ 800 = 45 очікуваних скасувань серед 200, а спостерегли 30.
Очікувані частоти можуть мати дробову частину; не заокруглюй їх. Це середні за умови «різниці немає», а не люди.
- Так«E = 300 × 230 ÷ 800 = 86,25 очікуваного покупця з дзвінком; ми побачили 105.»
- Не так«Очікувані покупці з дзвінком = 230 ÷ 2 = 115.»
Групи різного розміру; бери підсумок рядка, а не половину.
Хі-квадрат додає несподіванки й дорівнює z² для 2×2
Коли очікувані частоти є, кожна клітинка додає свою несподіванку: (O − E)² ÷ E, квадрат розриву між спостереженим і очікуваним, поділений на очікувану частоту. Статистика хі-квадрат — сума за всіма клітинками: χ² = Σ(O − E)² ÷ E.
Формула: O — спостережена частота; E — очікувана, якби групи не відрізнялися. Сума за всіма клітинками. · є вище
Для дзвінка Klasna про цілі чотири клітинки дають 4,076 + 1,645 + 2,446 + 0,987 ≈ 9,15. Для 1 ступеня свободи межа — 3,84, тож різниця значуща.
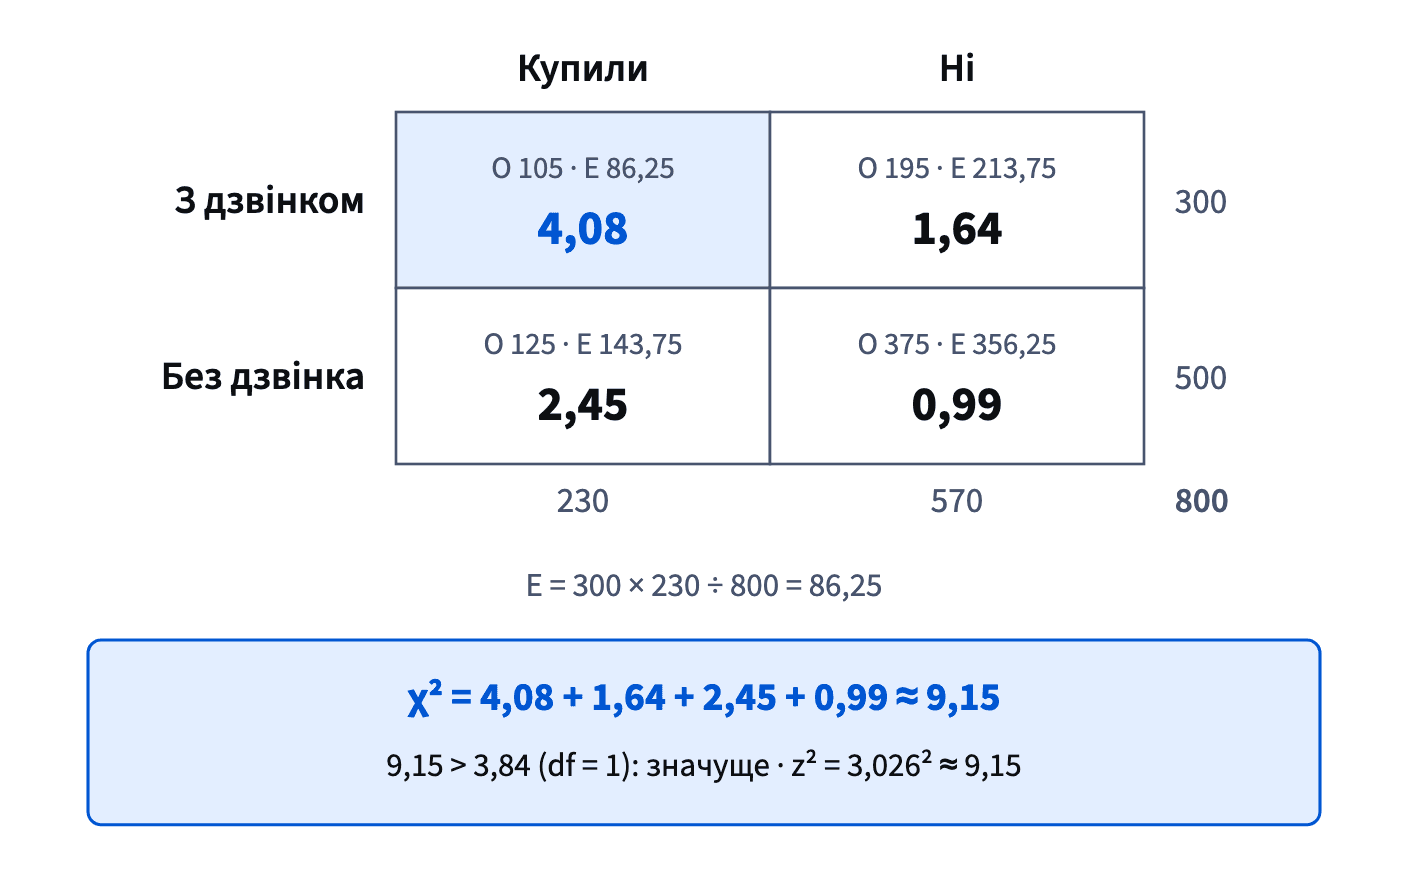
Для таблиці 2×2 є скорочений шлях: хі-квадрат дорівнює квадрату z для двох часток. Ті самі дані дають z ≈ 3,026, і 3,026² ≈ 9,15. Збігаються навіть межі: 1,96² = 3,84. Тож для двох груп і наслідку «так/ні» це один тест, записаний двома способами; z = 2,5 означає χ² = 6,25.
Хі-квадрат стає в пригоді на більших таблицях, як-от три пакети × дві вікові групи, де одне z не підходить.
- Так«z = 2,5 на таблиці 2×2, отже, χ² = 6,25 > 3,84: значуще в будь-якому разі.»
- Не так«χ² = 6,25 більше за 1,96, отже, значуще.»
Вердикт правильний, межа — ні: хі-квадрат з 1 df порівнюють із 3,84.
Потужність: площа зсунутої кривої
Потужність — шанс, що тест помітить ефект, який справді є. Почнімо зі зсунутої кривої: якщо справжній ефект — δ, а різницю вимірюють зі стандартною похибкою SE, виміряна різниця в середньому лежить на δ ÷ SE стандартних похибок від нуля. Двобічний тест на рівні 5% називає її значущою, коли вона потрапляє далі за 1,96. Тож потужність ≈ P(Z > 1,96 − δ ÷ SE).
Коли δ ÷ SE = 2,8, потужність — P(Z > −0,84) = 80%, звична ціль. Справжній ефект 2 в. п., виміряний із SE = 0,8 в. п., дає δ ÷ SE = 2,5, 1,96 − 2,5 = −0,54, і P(Z > −0,54) = 70,5%.
Тест paywall з курсу продуктової аналітики, 1 700 користувачів на варіант, 4% проти 5%: SE ≈ 0,0071, δ ÷ SE ≈ 1,41, потужність = P(Z > 0,55) ≈ 29%. Сім разів із десяти справжній приріст +1 в. п. вийшов би «не значущим».
- Так«δ ÷ SE = 2 ÷ 0,8 = 2,5, отже, потужність = P(Z > −0,54) ≈ 70,5%.»
- Не так«Потужність = P(Z > 1,96 + 2,5).»
Справжній ефект зсуває криву до межі, тож віднімай.
Що підвищує потужність
Потужність ≈ P(Z > 1,96 − δ ÷ SE) має три важелі, і лише два з них у твоїх руках.
- Менша SE. Більше людей або менш шумна метрика. Оскільки SE зменшується як √n (з уроку Квадратні корені і √n), учетверо більше користувачів зменшує її вдвічі. Для тесту paywall 6 800 на варіант замість 1 700 підіймають δ ÷ SE з 1,41 до приблизно 2,81, а потужність — з 29% до приблизно 80%.
- Межа. Суворіший рівень, 1% замість 5%, відсуває 1,96 до 2,576 і знижує потужність — це ціна меншої кількості хибних тривог.
- Ефект δ. Він такий, який є. Якщо планувати під більший ефект, ніж очікуєш, краще виглядатиме лише потужність на папері.
Підглядання чи додаткові метрики не допомагають: вони збільшують хибні тривоги, а не потужність.
Як це складається докупи: кожен тест порівнює статистику з критичним значенням своєї кривої; ступені свободи вибирають криву; хі-квадрат додає розриви між спостереженим і очікуваним; потужність — площа зсунутої кривої за межею. Наступний модуль — юніт-економіка, починаючи з маржинального доходу й беззбитковості.
- Так«Щоб мати потужність 80% для +1 в. п., потрібно близько 6 800 користувачів на варіант — учетверо більше, ніж планували.»
- Не так«Припустімо ефект +3 в. п., тоді 1 700 користувачів дадуть досить потужності.»
Потужність справжня лише для ефекту, якого ти справді очікуєш.
Готові потренуватися?
Виконайте вправи уроку й отримайте 250 балів, коли пройдете його вперше.
Розпочати вправи