

Теорія
Умовна ймовірність і таблиця 2×2
P(A | B) як частка всередині рядка, precision, recall і accuracy, відносний ризик і відношення шансів і чому напрям умови важливий.
~8 хв читання · 9 вправ · 250 балів
Перед початком
За умови, що
Ти досі в Klasna. Команда даних побудувала модель, що позначає учасників Club, які, ймовірно, скасують підписку, щоб підтримка зателефонувала їм першими. Числа за минулий місяць уже є: скільки було учасників, скільки скасували, скільки позначила модель і скільки з них справді скасували.
Ти прочитаєш «за умови, що» мовою ймовірностей, розкладеш числа в таблицю 2×2 і побачиш, чому ймовірність A за умови B — не те саме, що ймовірність B за умови A.
Умовна ймовірність: звужуємо знаменник
Умовна ймовірність P(A | B), що читається «A за умови B», — це ймовірність A, порахована лише серед випадків, де B правдива. Умова звужує знаменник: P(A | B) = P(A і B) ÷ P(B).
Модель відтоку Klasna показує, як сильно умова може зсунути число. Минулого місяця 80 із 1 000 учасників Club скасували підписку: P(скасує) = 0,08. Модель позначила 120 учасників, і 48 із них скасували: P(скасує | позначений) = 48 ÷ 120 = 0,40. Серед 880 непозначених скасували 32: P(скасує | не позначений) = 32 ÷ 880 ≈ 0,036.
Кількості й частки дають ту саму відповідь: 48 із 1 000 — це 0,048, 120 із 1 000 — 0,12, а 0,048 ÷ 0,12 = 0,40.
Перш ніж рахувати, проговори умову: «серед позначених…», «серед непозначених…». І діли лише на цю групу, а не на всіх.
- Так«Серед позначених учасників скасували 40%: 48 із 120.»
- Не так«Позначені, які скасували: 48 ÷ 1 000 = 4,8%.»
Це P(позначений і скасує), а не P(скасує | позначений).
Таблиця 2×2
Два запитання «так/ні» про тих самих людей дають таблицю 2×2: рядки — для одного запитання, стовпці — для іншого, і чотири клітинки, що разом дають загальну кількість. Для моделі відтоку Klasna рядки — що сказала модель (позначений, не позначений), а стовпці — що сталося (скасував, лишився).
Клітинки мають назви: істинно позитивні, позначені й скасували (TP = 48); хибно позитивні, або хибні тривоги, позначені, але лишилися (FP = 72); хибно негативні, або пропуски, не позначені, але скасували (FN = 32); істинно негативні, не позначені й лишилися (TN = 848).
Усі чотири клітинки дають рідко. Зазвичай відомі загальна кількість (1 000), підсумок рядка (120 позначених), підсумок стовпця (80, хто скасував) і одна клітинка (48). Решта — віднімання: 120 − 48 = 72, 80 − 48 = 32, 1 000 − 48 − 72 − 32 = 848. Перш ніж щось рахувати, перевір, що клітинки разом дають загальну кількість.
- Так48 + 72 + 32 + 848 = 1 000: таблиця сходиться.
- Не такЗаписати в клітинку «не позначений, лишився» 1 000 − 120 = 880.
880 — увесь рядок непозначених, обидва стовпці разом.
Precision і recall: той самий верх, різний низ
Більшість чисел із таблиці 2×2 — умовні ймовірності, які тримають той самий чисельник і змінюють знаменник.
- Precision = TP ÷ (TP + FP) читає рядок позначених: скільки з тих, кому дзвонить підтримка, справді збиралися скасувати? 48 ÷ 120 = 0,40.
- Recall = TP ÷ (TP + FN) читає стовпець тих, хто скасував: скількох із них модель упіймала? 48 ÷ 80 = 0,60.
- Accuracy = (TP + TN) ÷ усі рахує всі правильні клітинки: (48 + 848) ÷ 1 000 = 0,896.
- Базова частка не залежить від моделі: 80 ÷ 1 000 = 0,08.
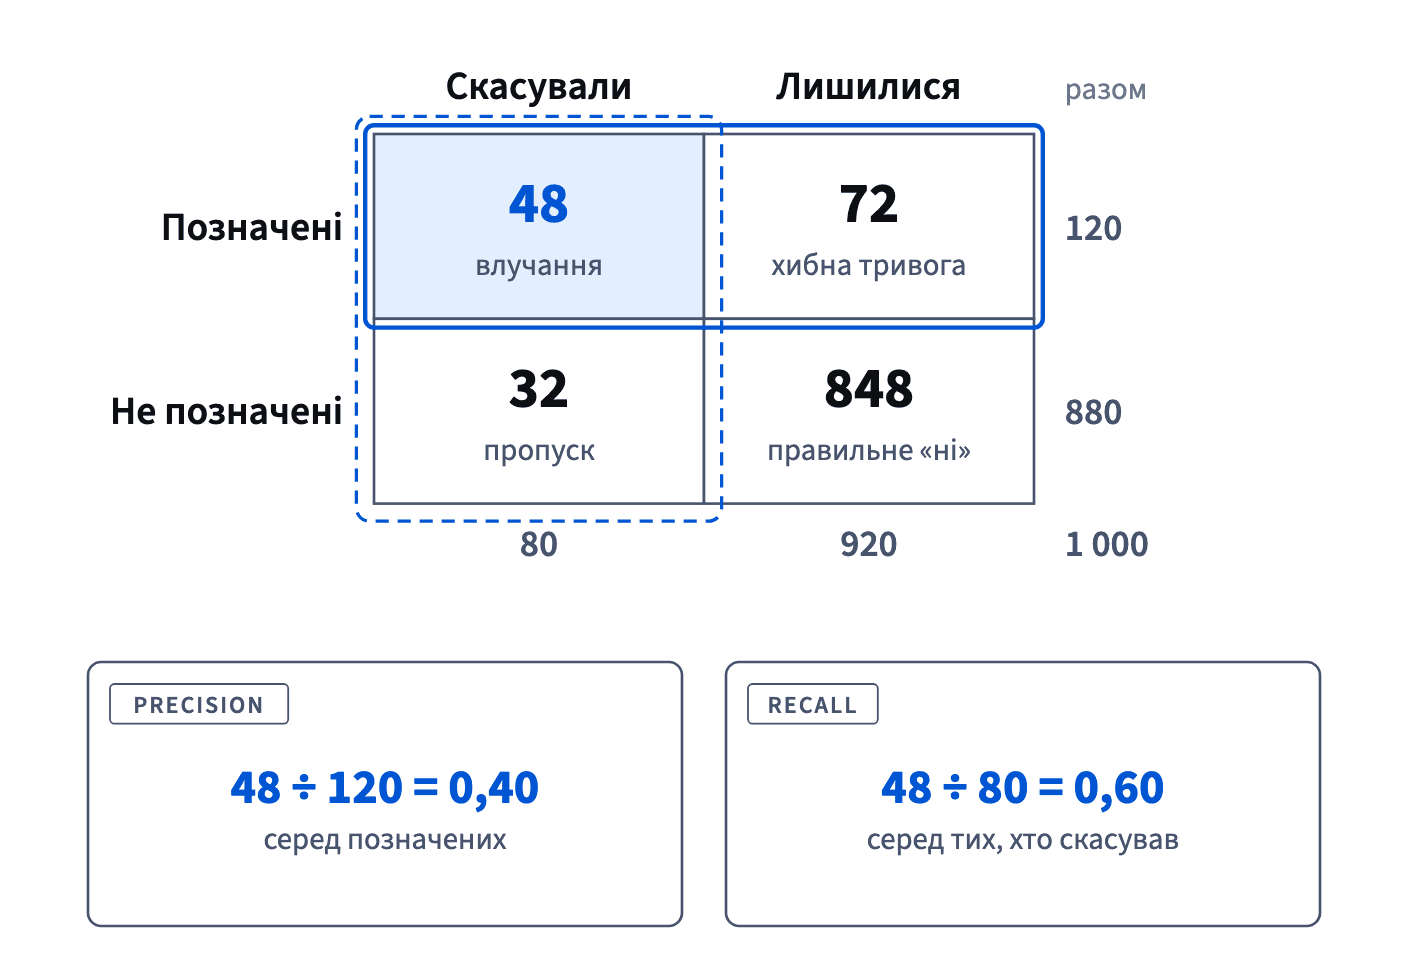
Щоб їх розрізняти, спитай, на що ділить число. Precision — частка позначок; recall — частка справжніх випадків. Ті самі 48 стоять угорі в обох, і саме тому у звітах їх так легко переплутати.
- Так«Precision 40%: 4 із 10 дзвінків потрапляють до того, хто збирався скасувати.»
- Не так«Recall 60%: 6 із 10 дзвінків корисні.»
Таке прочитання — для precision; recall — частка тих, хто скасував.
Accuracy прикрашає рідкісні події
Accuracy — частка всіх випадків, щодо яких модель мала рацію. Звучить як природна оцінка, але коли подія рідкісна, у ній переважають легкі «ні».
У Klasna Club за місяць скасовують лише 80 із 1 000 учасників. Модель, яка не позначає нікого, має рацію щодо всіх 920, хто лишається: accuracy 0,92. Справжня модель відтоку, яка ловить 48 скасувань, має 0,896 — менше, ніж бездіяльність. Accuracy винагороджує «ліниву» модель, бо істинно негативні заповнюють майже всю таблицю.
Тож коли команда діє за позначками, accuracy — не той заголовок. Постав натомість два запитання: скільки наших дій марні (precision) і скільки справжніх випадків прослизає повз (recall)? І порівнюй будь-яку accuracy з базовою часткою: модель корисна, лише якщо перевершує «завжди кажи ні», а це тут уже 1 − 0,08 = 0,92.
- Так«Precision 40%, recall 60%, базова частка 8%.»
- Не так«Модель точна на 89,6%, отже, працює.»
Модель без позначок мала б 92%.
Precision і recall тягнуть у різні боки
Модель відтоку не просто каже «так» чи «ні»: вона ставить оцінку кожному учаснику, а поріг обирає команда. Позначиш більше людей — упіймаєш більше справжніх випадків, але більше позначок виявляться хибними тривогами. Позначиш менше — станеться навпаки.
Перша модель позначає 120 учасників і ловить 48 із 80, хто скасовує: recall 0,60, precision 0,40. Друга позначає 300 і ловить 72: recall 72 ÷ 80 = 0,90, precision 72 ÷ 300 = 0,24. Жодна не краща просто так. Друга охоплює більше учасників, які збираються піти, але й марних дзвінків у неї більше.
Що важливіше, залежить від ціни кожної помилки. Якщо дзвінок дешевий, а втрата учасника дорога, високий recall вартий багатьох марних дзвінків. Якщо кожна дія дорога, наприклад знижка, важливіша precision. Подавай обидва числа й кажи, який компроміс обрали.
- Так«Позначивши 300, маємо recall 90% і precision 24%; підтримка впорається з 300 дзвінками.»
- Не так«Друга модель краща: вона ловить більше.»
Мовчить про 228 марних дзвінків.
Напрям умови
P(A | B) і P(B | A) мають спільний чисельник — випадки, коли стається і те, й інше, — але ділять на різні групи, тож зазвичай це різні числа. P(скасує | позначений) = 48 ÷ 120 = 0,40, а P(позначений | скасував) = 48 ÷ 80 = 0,60. Переставлена умова — найпоширеніша помилка з імовірностями у звітах.
Найболючіше це в результатах тестів. p-значення — це P(такі крайні дані | ефекту немає), а не P(ефекту немає | дані). Деякі звіти показують інший напрям: «імовірність, що B кращий за A: 59%», тобто P(B краще | дані) = 0,59. Читай буквально: з огляду на побачене B краще трохи частіше, ніж дало б підкидання монети. Це не означає, що B конвертує на 59% краще чи що 59% користувачів обрали B.
Перш ніж наводити умовну ймовірність, перекажи обидві сторони словами: «частка X серед Y». Якщо речення змінює зміст, коли X і Y міняються місцями, змінюється й число.
- Так«З огляду на дані B краще з імовірністю 0,59 — слабкий доказ.»
- Не так«B на 59% краще за A.»
Це ймовірність бути кращим, а не розмір ефекту.
Відносний ризик: порівнюємо два рядки
Таблиця 2×2 може й порівнювати дві групи: рядки — групи, стовпці — наслідок. Найпростіше порівняння — відносний ризик: імовірність наслідку в одній групі, поділена на його ймовірність в іншій, RR = p₁ ÷ p₂.
Klasna дала частині учнів після пробного уроку короткий дзвінок про цілі: купили 105 із 300 (0,35) проти 125 із 500 без дзвінка (0,25). RR = 0,35 ÷ 0,25 = 1,40: із дзвінком купівля була в 1,4 раза ймовірнішою. RR = 1 означає відсутність різниці; менше 1 — наслідок у першій групі менш імовірний.
Допомагають дві звички. Рахуй ймовірність кожної групи в її власному рядку, а не від загальної кількості. І кажи, яка група вгорі: 1,40 в один бік — це 0,71 в інший (0,25 ÷ 0,35). «Купівля була в 1,4 раза ймовірнішою» і «дзвінок підняв купівлі на 40%» — одне й те саме; «на 140%» — ні.
- Так«Із дзвінком купили 35%, без нього 25%: відносний ризик 1,40.»
- Не так«Група з дзвінком зробила 105 із 230 купівель, тож RR = 0,46.»
Ділить на стовпець купівель, а не на рядок кожної групи.
Відношення шансів
Шанси порівнюють «так» із «ні» всередині однієї групи: шанси = p ÷ (1 − p), тобто ймовірність, поділена на доповнення події, як в уроці e, ln, шанси й сигмоїда. Відношення шансів ділить шанси однієї групи на шанси іншої: OR = (a ÷ b) ÷ (c ÷ d) = ad ÷ bc, де a і b — кількості «так» і «ні» в першому рядку, c і d — у другому.
Для дзвінка про цілі: шанси 105 ÷ 195 = 0,538 із дзвінком і 125 ÷ 375 = 0,333 без нього, тож OR ≈ 1,62, тоді як відносний ризик був 1,40. Відношення шансів завжди далі від 1, бо шанси розтягуються швидше за ймовірності, коли p росте. Для рідкісних наслідків, 2% проти 1%, обидва числа майже збігаються.
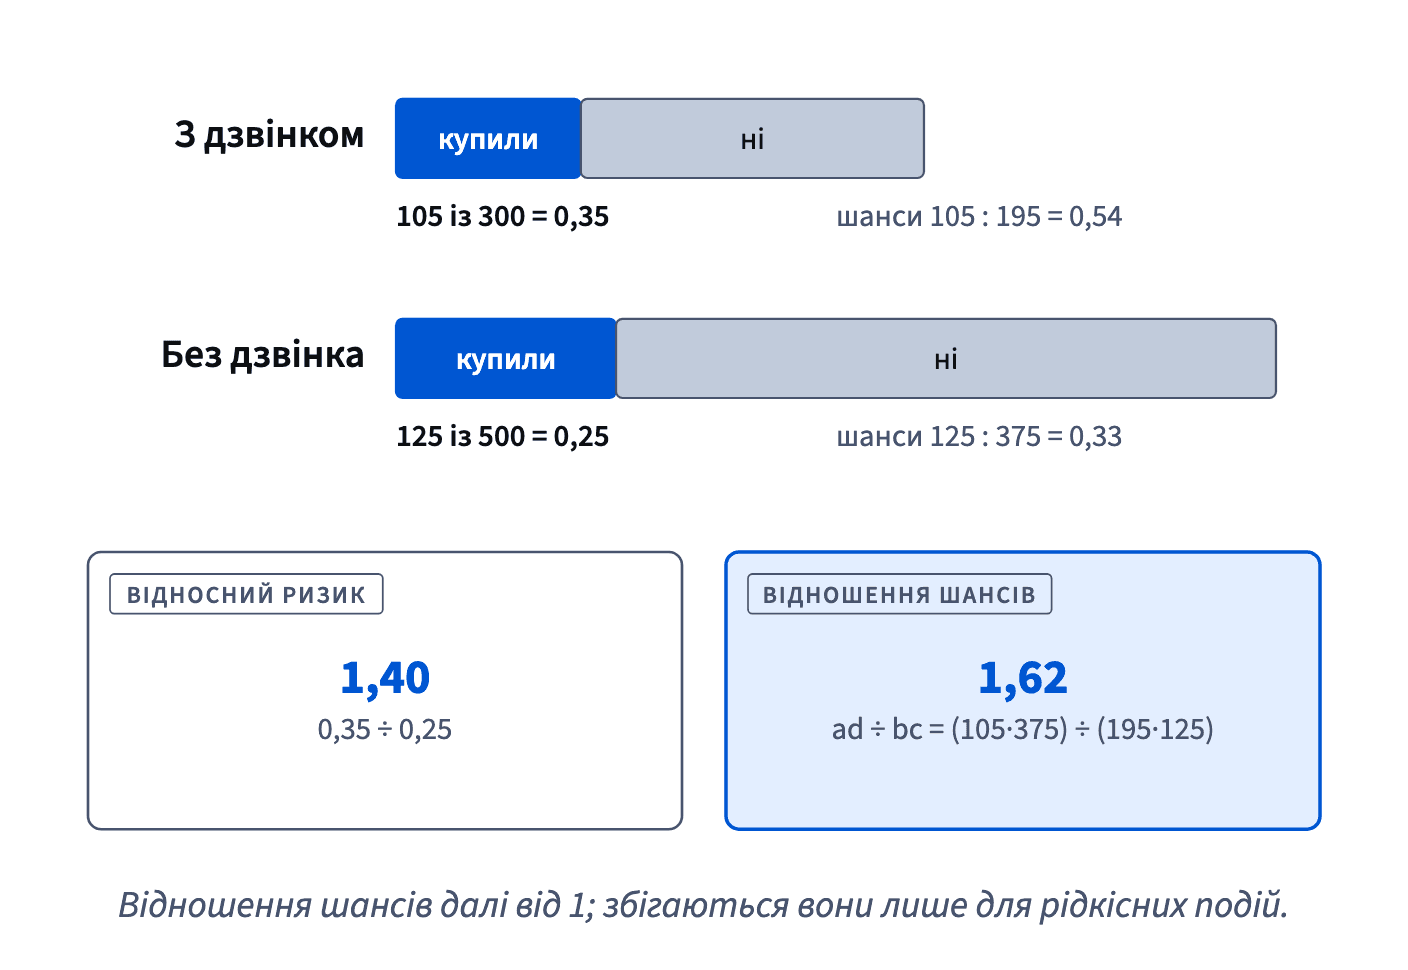
Логістична регресія подає відношення шансів, тож читай 1,62 як «шанси в 1,62 раза вищі», а не «у 1,62 раза ймовірніше».
Як це складається докупи: умова звужує знаменник; таблиця 2×2 містить усі кількості, і кожна метрика бере свій рядок, стовпець чи загальну суму. Наступний урок зважує наслідки за їхньою ймовірністю: математичне сподівання.
- Так«OR 1,62 для шансів купівлі; RR 1,40 для ймовірності купівлі.»
- Не так«Учні з дзвінком купували в 1,62 раза ймовірніше.»
Відношення шансів прочитано так, ніби це відносний ризик.
Готові потренуватися?
Виконайте вправи уроку й отримайте 250 балів, коли пройдете його вперше.
Розпочати вправи