

Теорія
Вибірка, генеральна сукупність і нормальний розподіл
Вибірка і генеральна сукупність: чому ми вивчаємо вибірки, щоб дізнатися про всіх користувачів, чому нормальний розподіл трапляється всюди і як їх пов'язує центральна гранична теорема.
~9 хв читання · 11 вправ · 250 балів
Перед початком
Від 500 замовлень до всіх покупців
Новий модуль у Котокормі: незабаром продуктова команда порівнюватиме групи й читатиме A/B-тести. Але спершу Alex, аналітик команди, хоче, щоб усі домовилися, що саме вимірюється. У тебе вже є таблиця з 500 замовлень за минулий місяць, але що вони можуть сказати про всіх покупців — і тих, хто вже купував, і тих, хто ще купуватиме?
Цей урок про вибірку й генеральну сукупність, нормальний розподіл у формі дзвона і теорему, яка їх пов'язує.
Вибірка, генеральна сукупність, параметр, статистика
Майже кожне число, на яке дивиться продуктова команда, походить із вибірки: тієї частини користувачів чи замовлень, яку справді виміряли. А цікавить тебе генеральна сукупність: усі, кого стосується рішення, зокрема клієнти, які ще не прийшли. Виміряти всю генеральну сукупність майже ніколи не вдається, тож міряють вибірку й узагальнюють.
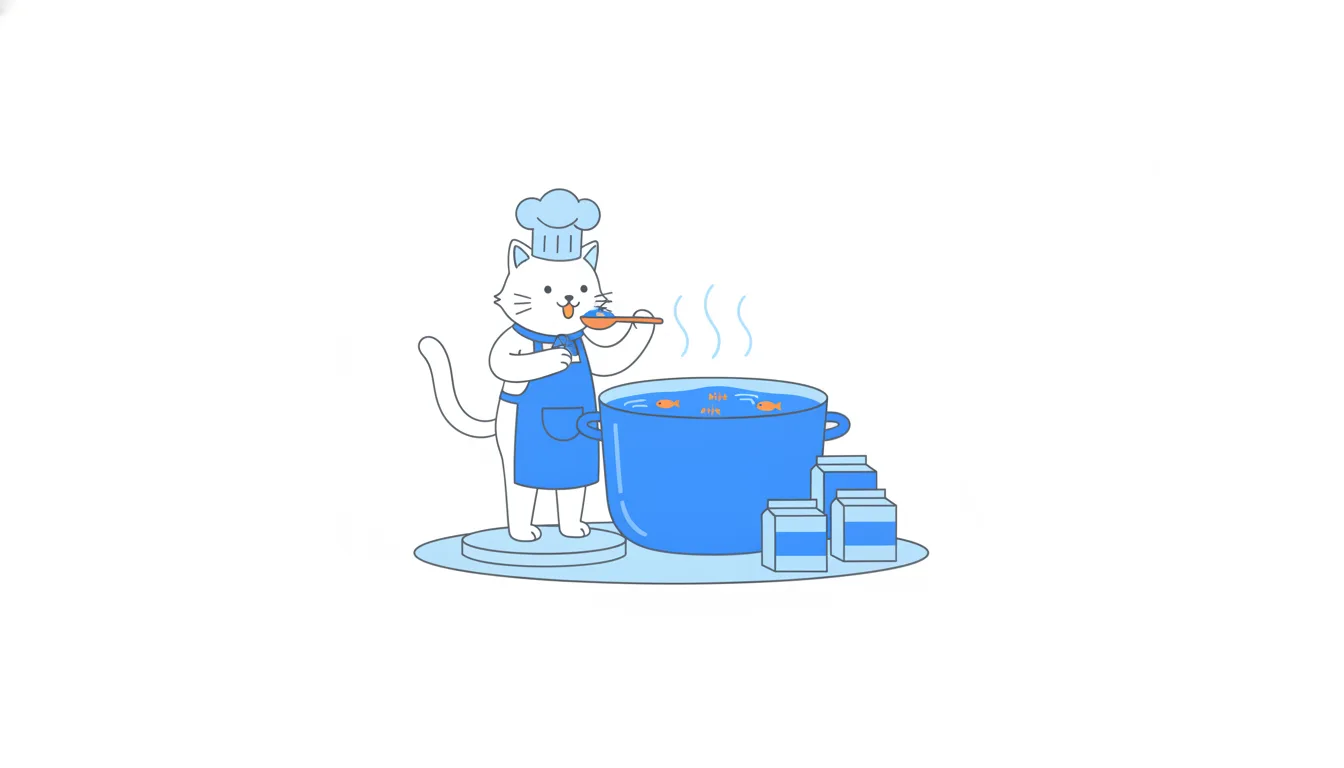
Той самий поділ стосується й чисел:
- параметр описує генеральну сукупність, наприклад справжню середню суму замовлення всіх клієнтів Котокорму. Він існує, але ти його не знаєш;
- статистику (оцінку) обчислюють із вибірки, наприклад середнє 500 вивантажених замовлень. Її знаєш точно і використовуєш, щоб оцінити параметр.
Швидка перевірка: «чи це число пораховано з даних, які в мене є?» Якщо так, це статистика. Середній бал опитування 10% клієнтів лишається статистикою, навіть якщо ним хочуть описати всіх клієнтів. Описати всіх — це мета, а не властивість числа.
- Так«Середнє наших 500 замовлень — 45 дол., тож ми оцінюємо, що середнє для всіх клієнтів близько 45 дол.»
Статистика, яку використовують як оцінку параметра.
- Не так«Середнє замовлення всіх наших клієнтів — 45 дол.»
Видає число з вибірки за сам параметр.
Чотири слова, на які спирається решта курсу
Статистика поєднує ці слова в пари, і їх зручно запам'ятовувати саме так:
- генеральна сукупність і параметр: уся група і справжнє число про неї. Зазвичай невідоме;
- вибірка і статистика (оцінка): частина, яку виміряли, і число, обчислене з неї. Завжди відоме.
Для двох сторін є й різні позначення. Значення генеральної сукупності позначають грецькими літерами: μ (мю) — середнє, σ (сигма) — стандартне відхилення. Вибіркові — латинськими: x̄ (ікс із рискою) — вибіркове середнє, s — вибіркове стандартне відхилення. Якщо формула містить μ і σ, вона припускає, що ти знаєш усю сукупність; якщо x̄ і s, вона працює з даними, які в тебе є.
Навіщо так прискіпуватися до слів? Бо кожен критерій далі в курсі ставить те саме запитання: що ця статистика каже про параметр? Якщо їх сплутати, звіт непомітно обіцяє більше певності, ніж дають дані.
- Такx̄ = 45 дол. з 500 замовлень (статистика); μ = невідоме середнє всіх замовлень (параметр).
- Не так«μ = 45 дол.» поруч із вибіркою з 500 замовлень.
Грецька літера стверджує, що виміряно всіх.
Нормальний розподіл і правило 68-95-99,7
Нормальний розподіл — це симетрична крива-дзвін. Значення скупчуються біля середини й рівномірно рідшають з обох боків, а середнє, медіана і мода стоять у центрі. Він зазвичай виникає, коли значення складається з багатьох дрібних незалежних впливів.
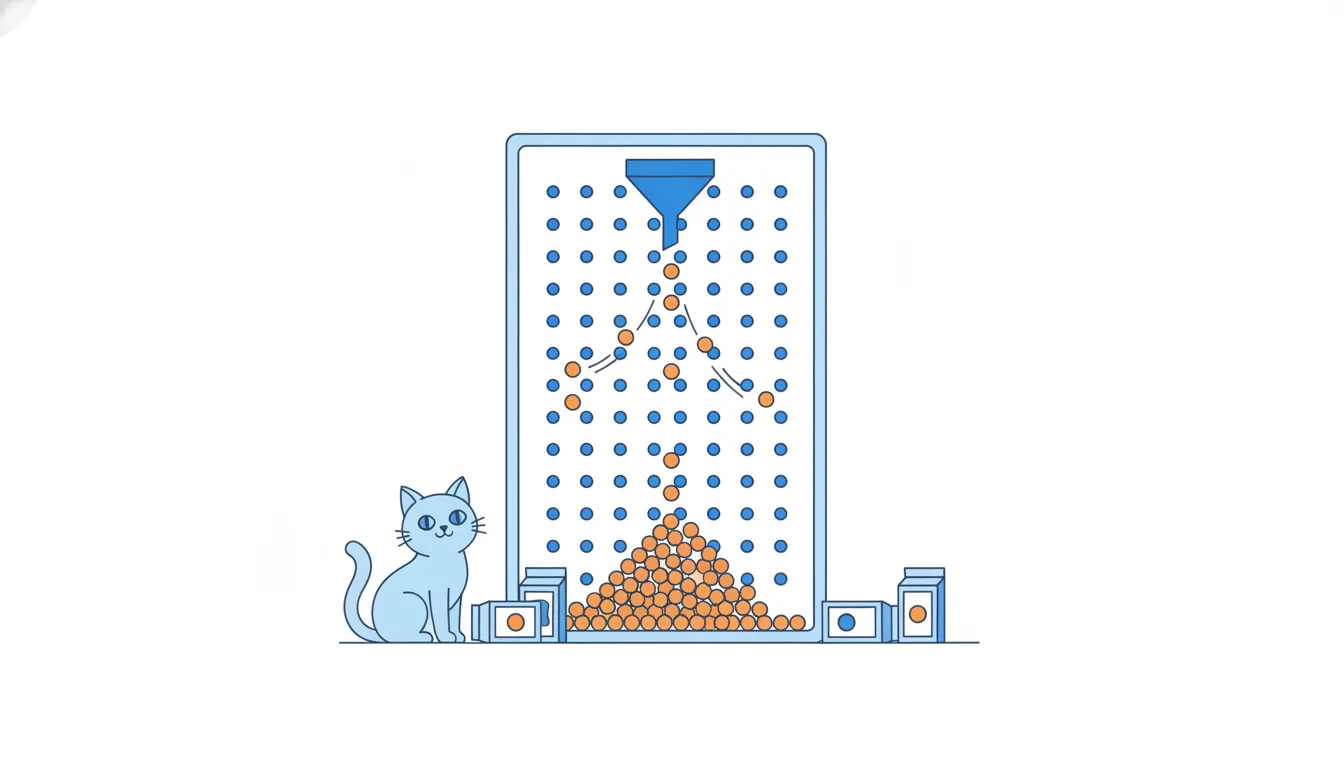
Його повністю описують два числа: середнє (де центр) і стандартне відхилення (наскільки широкий дзвін). Знаючи їх, емпіричне правило підказує, де лежить більшість значень:
- приблизно 68% — у межах 1 стандартного відхилення від середнього;
- приблизно 95% — у межах 2;
- приблизно 99,7% — у межах 3.
Дані графіка
| z-оцінка | Щільність |
|---|---|
| -3 | 0,004 |
| -2,5 | 0,018 |
| -2 | 0,054 |
| -1,5 | 0,13 |
| -1 | 0,242 |
Показати ще 8 рядків
| -0,5 | 0,352 |
| 0 | 0,399 |
| 0,5 | 0,352 |
| 1 | 0,242 |
| 1,5 | 0,13 |
| 2 | 0,054 |
| 2,5 | 0,018 |
| 3 | 0,004 |
Якщо середнє — 50 дол., а стандартне відхилення — 12 дол., то приблизно 68% замовлень лежать між 38 і 62 дол., приблизно 95% — між 26 і 74 дол., а майже всі — між 14 і 86 дол.
Правило працює лише для даних, схожих на дзвін. Реальні суми замовлень часто мають довгий хвіст великих покупок, тож спершу глянь на гістограму.
- ТакСереднє 50 дол., СВ 12 дол.: приблизно 95% замовлень між 26 і 74 дол. (50 ± 2 × 12).
- Не такЗастосовувати 68-95-99,7 до сум замовлень із довгим хвостом гуртових покупок, не перевіривши форму.
Правило описує дзвін, а не будь-які дані.
Звідки береться зміщення вибірки
Вибірка корисна, лише якщо вона схожа на генеральну сукупність у тому, що важливо. Зміщення вибірки виникає, коли шанс потрапити у вибірку пов'язаний із тим, що ти вимірюєш. Тоді більша вибірка не рятує: ти просто отримуєш точнішу хибну відповідь.
Два типові шляхи:
- канал відсіює людей. Опитування лише через пуш у застосунку охоплює користувачів застосунку й пропускає всіх, хто замовляє на сайті. Якщо користувачі застосунку задоволеніші чи лояльніші, середнє зсувається;
- момент відсіює людей. Опитування одразу після звернення в підтримку переважно охоплює тих, у кого була проблема.
Способи, які розривають цей зв'язок, підходять: випадковий відбір із повного списку клієнтів або кожне 20-те ім'я зі списку, відсортованого за чимось стороннім, наприклад за алфавітом.
Перш ніж довіряти числу, запитай: хто не міг потрапити в цю вибірку і чи відповів би він інакше? Якщо так, результат описує підгрупу, а не всіх клієнтів.
- ТакВипадково відібрати 2 000 клієнтів із повної бази й надіслати лист кожному.
Кожен має однаковий шанс отримати запитання.
- Не такПоказувати опитування про задоволеність лише на екрані «Замовлення доставлено» в застосунку.
Ті, хто купує на сайті, і ті, кому не доставили, його не побачать.
z-оцінка: відстань від середнього в стандартних відхиленнях
z-оцінка показує, на скільки стандартних відхилень значення віддалене від середнього:
z = (x − μ) / σ
Формула: z-оцінка: відніми від значення x середнє генеральної сукупності μ, тоді поділи на стандартне відхилення генеральної сукупності σ. · є вище
Спершу відніми середнє, потім поділи на стандартне відхилення. Порядок важливий: якщо спершу поділити, вийде нісенітниця.
Якщо μ = 50 дол., а σ = 12 дол., то замовлення на 74 дол. має z = (74 − 50) / 12 = 24 / 12 = 2,0. Замовлення на 38 дол. має z = (38 − 50) / 12 = −1,0: одне стандартне відхилення нижче за середнє. z = 0 означає рівно середнє.
Навіщо це? z-оцінка зводить зовсім різні величини до однієї шкали. Замовлення на 74 дол. і сесію на 9 хвилин напряму не порівняти, а «на 2 стандартні відхилення вище за звичайне» — можна. Разом з емпіричним правилом z-оцінка ще й показує, наскільки незвичне значення в приблизно нормальному розподілі: за межами ±2 рідкісне (разом приблизно 5% значень), за межами ±3 — дуже рідкісне.
Пам'ятай, що це прочитання припускає форму дзвона; у скошеному розподілі z = 2 на боці довгого хвоста трапляється частіше.
- Так(74 − 50) / 12 = 2,0
Спершу відняти середнє, потім поділити.
- Не так74 / 12 ≈ 6,17
Середнє забуто, тож результат не є відстанню від будь-чого.
Вибірковий розподіл і центральна гранична теорема
Уяви, що ти береш багато різних вибірок по 40 замовлень і рахуєш середнє кожної. Середні не збігатимуться: кожна вибірка захоплює трохи інших клієнтів. Розкид усіх можливих вибіркових середніх — це вибірковий розподіл середнього.
Центральна гранична теорема (ЦГТ) каже про його форму дещо несподіване: зі зростанням обсягу вибірки n вибірковий розподіл середнього дедалі ближчий до нормального, хоч би якою була форма самих даних. Суми замовлень можуть бути сильно скошені, з довгим хвостом гуртових покупок, а середні вибірок із них однаково утворять майже дзвін.
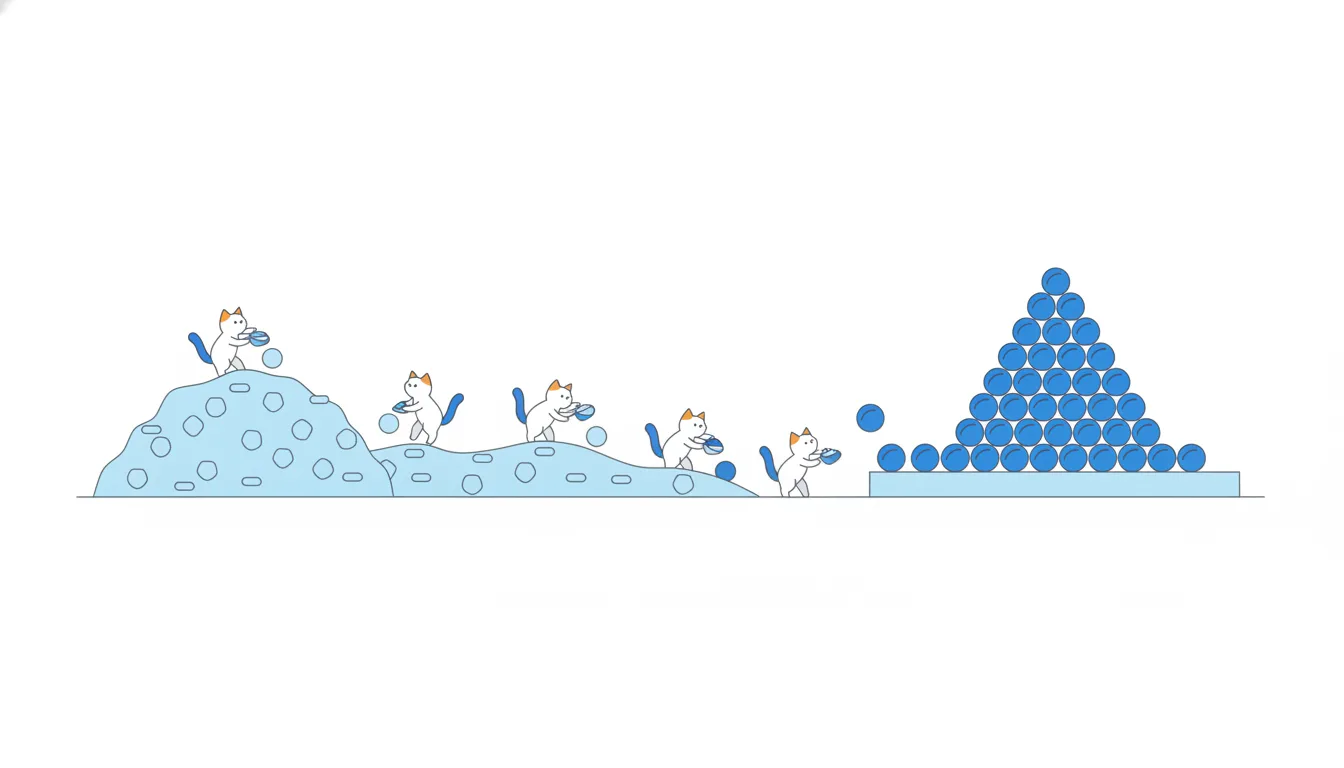
Чого ЦГТ не каже:
- вона не робить нормальними самі дані. Окремі замовлення лишаються скошеними, скільки б їх не зібрати;
- вона не називає одного чарівного n. Для злегка скошених даних може вистачити кількох десятків спостережень у вибірці; для даних із великими викидами потрібно значно більше.
Саме тому критерії, побудовані на нормальній кривій, працюють і з бізнес-метриками, які самі далекі від нормальних.
- Так«Суми замовлень скошені, але середнє 200 замовлень розподілене майже нормально, тож критерій на основі нормального розподілу доречний».
- Не так«Ми зібрали 5 000 замовлень, тож за ЦГТ суми замовлень тепер нормальні».
ЦГТ стосується вибіркових середніх, а не самих значень.
Стандартна похибка — не стандартне відхилення
Два розкиди, два запитання:
- стандартне відхилення (s) каже, наскільки окремі значення відрізняються одне від одного. Одне замовлення — 20 дол., інше — 70 дол.;
- стандартна похибка (СП) каже, наскільки зсунулося б вибіркове середнє, якби відбір повторили. Це ширина вибіркового розподілу.
Її оцінюють з однієї вибірки:
СП = s / √n
Формула: Стандартна похибка середнього: вибіркове стандартне відхилення s, поділене на корінь квадратний з обсягу вибірки n. · є вище
Якщо s = 18 дол., а n = 36 замовлень: СП = 18 / √36 = 18 / 6 = 3 дол. Окремі замовлення коливаються приблизно на 18 дол., а середнє з 36 таких визначене з точністю до кількох доларів.
Стандартна похибка зменшується зі зростанням n, бо усереднення гасить випадкові злети й падіння. Стандартне відхилення від більшої кількості даних не зменшується: воно описує клієнтів, а не твою невизначеність.
Типова помилка — забути корінь і ділити на саме n: 18 / 36 = 0,5 занижує невизначеність ушестеро. Інша — показати СП там, де потрібен розкид окремих значень: тоді дані здаються значно однорідніші, ніж є.
- ТакСП = 18 / √36 = 18 / 6 = 3
- Не такСП = 18 / 36 = 0,5
Ділить на n замість √n.
Закон кореня: чому точність дорожчає
Оскільки стандартна похибка ділиться на √n, а не на n, точність росте повільно. Щоб зменшити стандартну похибку вдвічі, потрібно вчетверо більше даних, а не вдвічі.
Формула: Стандартна похибка середнього: вибіркове стандартне відхилення s, поділене на корінь квадратний з обсягу вибірки n. · є вище
Якщо s = 18 дол.:
- n = 36 дає СП = 18 / 6 = 3,00 дол.;
- n = 144 дає СП = 18 / 12 = 1,50 дол.;
- n = 576 дає СП = 18 / 24 = 0,75 дол.
Кожне наступне зменшення вдвічі коштує вчетверо більшої вибірки. Подвоєння з 36 до 72 замовлень зменшує СП лише з 3,00 до приблизно 2,12 дол.
Щоб знайти потрібну вибірку для цільової СП, переверни формулу: √n = s / СП, а потім піднеси до квадрата. Для цілі 1,50 дол.: √n = 18 / 1,5 = 12, тож n = 144.
Це важливо щоразу, коли хтось просить «просто більшу вибірку». Перші кілька сотень спостережень дають багато точності; далі кожен наступний крок точності коштує тижнів трафіку. Часто дешевше погодитися на трохи ширший діапазон або зменшити шум у метриці, ніж збирати далі.
- ТакЦільова СП 1,50 дол.: √n = 18 / 1,5 = 12, n = 144 (4 × 36).
- Не так«Удвічі більше замовлень — удвічі менша похибка»: n = 72.
З 72 замовленнями СП усе ще приблизно 2,12 дол.
Як читати стандартну похибку у звіті
Стандартна похибка відповідає на одне запитання: наскільки вибіркове середнє ймовірно відрізняється від середнього генеральної сукупності? Вона описує не клієнтів, а твою невизначеність щодо середнього.
Зручне грубе прочитання: середнє генеральної сукупності, імовірно, лежить у межах приблизно 2 стандартних похибок від вибіркового середнього. Якщо вибіркове середнє — 45 дол., а СП = 3 дол., це 45 ± 6, тобто приблизно від 39 до 51 дол. для середнього замовлення всіх клієнтів. Наступні уроки зроблять цей діапазон точним; поки що «середнє ± 2 СП» — добра перевірка на здоровий глузд.
Класична помилка — застосувати цей діапазон до окремих замовлень. Із s = 18 дол. окремі замовлення розкидані значно ширше: якби вони були приблизно нормальними, близько 95% лежали б у межах 45 ± 36, від 9 до 81 дол. Діапазон 39–51 дол. стосується середнього, а не конкретного клієнта.
Коли пишеш результат, уточнюй, про який розкид мова: «замовлення коливаються приблизно на 18 дол. (СВ)» чи «середнє відоме з точністю приблизно до 6 дол. (2 СП)».
- Так«Середнє замовлення 45 дол.; справжнє середнє, імовірно, приблизно між 39 і 51 дол.»
- Не так«Більшість клієнтів витрачає від 39 до 51 дол.»
Діапазон СП використано для опису окремих клієнтів.
Готові потренуватися?
Виконайте вправи уроку й отримайте 250 балів, коли пройдете його вперше.
Розпочати вправи