

Теорія
t-критерій для залежних вибірок: до і після
Порівняння тих самих користувачів до і після зміни: t-критерій для залежних вибірок і T-критерій Вілкоксона.
~10 хв читання · 11 вправ · 250 балів
Перед початком
Чи спрацювала програма лояльності?
Минулого місяця Котокорм запустив програму лояльності, і маркетинг приніс продуктовій команді запитання: чи справді вона підняла місячні витрати, чи вони й так поповзли б угору? Цього разу дані стосуються тих самих восьми покупців до і після запуску.
Від цього залежить, який критерій підходить. У цьому уроці ти порівняєш «до» і «після» за допомогою t-критерію для залежних вибірок і побачиш, чому, вважаючи тих самих людей двома окремими групами, ти втрачаєш частину інформації.
Залежні вибірки: кожен клієнт — сам собі база
Дві вибірки залежні (парні), коли кожне значення в одній має природну пару в іншій: зазвичай того самого клієнта, виміряного двічі, до і після зміни. Вибірки незалежні, коли дві групи — різні люди, як в A/B-тесті.
Дизайн визначає критерій. Для програми лояльності Котокорм відстежив місячні витрати тих самих 8 клієнтів до і після. Ці клієнти дуже різні між собою: один витрачає 29 дол. на місяць, інший — 60 дол. Цей розкид реальний, але не має жодного стосунку до програми.
t-критерій Стьюдента для незалежних вибірок розглядає «до» і «після» як дві непов'язані групи, тож увесь розкид між клієнтами потрапляє в його шум. t-критерій для залежних вибірок натомість працює зі зміною кожного клієнта. Віднявши «до» від «після», ми прибираємо особистий рівень і залишаємо лише те, наскільки клієнт змістився.
Результат: значно менше шуму й значно більша потужність на тих самих даних. Єдина вимога — пари мають бути справжніми: ті самі люди або навмисно зіставлені.
- ТакТі самі 8 клієнтів до і після → одна колонка різниць → t-критерій для залежних вибірок.
- Не такТі самі 8 клієнтів, але порівняти середнє «до» із середнім «після» як дві групи.
Викидає парування й ховає ефект у шумі між клієнтами.
Що вважається парою
Критерій для залежних вибірок віднімає одне значення від його пари, тож кожне значення потребує партнера, який справді з ним пов'язаний. Типові пари в продуктовій роботі:
- той самий користувач двічі: витрати до і після програми лояльності, час на старому й новому оформленні замовлення;
- той самий користувач, дві умови: одна людина оцінює обидві версії сторінки;
- навмисно зіставлені одиниці: два магазини, підібрані за розміром і містом, один отримує зміну.
Що не є парою:
- покупці цього місяця проти покупців минулого. Частина збігається, але багато людей різні, і зв'язку один до одного немає;
- дві групи A/B-тесту. Користувачів розподілено випадково, тож кожна людина трапляється лише раз.
Якщо дані не можна записати як один рядок на одиницю з колонками «до» і «після», вони не парні.
Критерій для залежних вибірок на непарних даних — не дрібна помилка: віднімання поєднує випадкових незнайомців, і результат безглуздий. Незалежний критерій на парних даних коректний, але марнотратний: втрачаєш потужність, за яку вже заплатили.
- ТакОдин рядок на клієнта: U1 42 → 47, U2 38 → 40, … → парні дані.
- Не такПоєднати 200 покупців вересня з 200 покупцями жовтня за порядком у списку.
Різні люди в довільному порядку — це не пари.
Крок перший: середня різниця
Парний аналіз починається з того, що кожну пару зводять до одного числа: різниці d = після − до.
Для 8 клієнтів програми лояльності:
- U1 47 − 42 = 5, U2 40 − 38 = 2, U3 59 − 51 = 8, U4 30 − 29 = 1;
- U5 66 − 60 = 6, U6 37 − 33 = 4, U7 50 − 47 = 3, U8 62 − 55 = 7.
Дані графіка
| Клієнт | Після − до |
|---|---|
| U1 | 5 |
| U2 | 2 |
| U3 | 8 |
| U4 | 1 |
| U5 | 6 |
Показати ще 3 рядки
| U6 | 4 |
| U7 | 3 |
| U8 | 7 |
Середня різниця d̄ = (5 + 2 + 8 + 1 + 6 + 4 + 3 + 7) / 8 = 36 / 8 = 4,50 дол.
Далі дві початкові колонки зникають. Запитання стає одновибірковим: чи відрізняється середнє цих 8 різниць від нуля?
Дві звички тримають розрахунок чистим. По-перше, зафіксуй напрям (після мінус до) і тримайся його для кожного клієнта; змішані напрями перевертають знаки й гасять реальні зміни. По-друге, подивися на різниці до будь-якої перевірки. Тут усі 8 додатні, і це вже багато каже. Одна величезна різниця серед малих попередила б про викид.
Середня різниця дорівнює також різниці двох середніх (48,875 − 44,375 = 4,5), але лише парний погляд показує, наскільки стабільна зміна.
- Такd̄ = 36 / 8 = 4,50 дол.
- Не такd̄ = 36 / 7 ≈ 5,14 дол.
n − 1 потрібне для дисперсії, а не для середнього.
Крок другий: стандартна похибка різниць
Далі потрібно знати, наскільки середня різниця хиталася б від вибірки до вибірки. Це стандартна похибка, обчислена лише з різниць:
SE = s_d / √n
де s_d — стандартне відхилення різниць, а n — кількість пар.
Для 8 клієнтів: квадрати відхилень різниць від 4,5 в сумі дають 42. Поділивши на n − 1 = 7, отримуємо дисперсію 6, тож s_d = √6 ≈ 2,449. Тоді SE = 2,449 / √8 = 2,449 / 2,828 ≈ 0,87 дол.
Порівняй із розкидом самих витрат: до і після клієнти коливаються зі стандартним відхиленням приблизно 11–13 дол. Різниці коливаються лише приблизно на 2,45 дол., бо особистий рівень кожного клієнта віднято. Саме звідси потужність критерію для залежних вибірок.
Помилка, якої варто уникати: брати стандартне відхилення самих значень «до» чи «після» замість s_d. Так шум між клієнтами повертається назад, а SE виходить у кілька разів завеликою.
- ТакSE = 2,449 / √8 ≈ 0,87
- Не такSE = 10,8 / √8 ≈ 3,83 (стандартне відхилення витрат «до»)
Бере розкид самих значень замість розкиду різниць.
Крок третій: t, ступені свободи і рішення
t-статистика критерію для залежних вибірок вимірює середню різницю в стандартних похибках:
t = d̄ / (s_d / √n) = 4,5 / 0,866 ≈ 5,20
Формула: t-критерій Стьюдента для залежних вибірок: середня різниця, поділена на стандартну похибку різниці (стандартне відхилення різниць, поділене на корінь із n пар). · є вище
Ступені свободи рахують пари, а не значення: df = n − 1 = 8 − 1 = 7. 8 клієнтів дали 16 чисел, але лише 8 незалежних різниць.
Для двобічного критерію при α = 0,05 і df = 7 критичне значення — приблизно 2,365. Наше t більш ніж удвічі більше, а p-значення — приблизно 0,001. Якби програма насправді нічого не змінювала, така велика середня різниця відносно її шуму була б дуже рідкісною.
Це значущий доказ того, що витрати зросли, приблизно на 4,50 дол. на клієнта на місяць. Але ще не доказ, що це спричинила програма лояльності: без контрольної групи сезонне зростання виглядало б так само.
Дві помилки, яких варто уникати: брати df = 14 (n1 + n2 − 2, формула для незалежних вибірок), що дає трохи нижче критичне значення, близько 2,145, і ділити на s_d замість SE (4,5 / 2,449 ≈ 1,84), забуваючи про √n.
- Такt = 4,5 / 0,866 ≈ 5,20, df = 7, > 2,365
- Не такt = 4,5 / 2,449 ≈ 1,84, «не значуще»
Ділить на стандартне відхилення різниць замість їхньої стандартної похибки.
Ті самі дані, два критерії, дуже різні відповіді
Якщо застосувати обидва критерії до даних програми лояльності, контраст разючий:
- t-критерій Стьюдента для незалежних вибірок: середнє «до» 44,38 дол., «після» 48,88 дол. Витрати клієнтів коливаються зі стандартним відхиленням приблизно 11–13 дол., тож розрив у 4,50 дол. малий на тлі цього шуму: t ≈ 0,76, p ≈ 0,46;
- t-критерій для залежних вибірок: 8 різниць — від +1 до +8, зі стандартним відхиленням лише 2,45 дол.: t ≈ 5,20, p ≈ 0,001.
Ті самі числа, та сама середня зміна, протилежні висновки. Уся різниця — у шумі. Незалежний критерій вважає шумом розрив між клієнтом на 29 дол. і клієнтом на 60 дол., хоча той не має стосунку до програми. Критерій для залежних вибірок його віднімає.
Саме тому критерій обирає дизайн, а не бажаний результат. Тих самих людей виміряно двічі? Парний. Дві окремі групи? Незалежний. Провести обидва й показати той, що подобається, — різновид підгонки p-значення.
Це також показує, чому незначущий незалежний критерій на парних даних майже нічого не каже: це був не той інструмент, а не доказ відсутності ефекту.
- Так«Ті самі 8 клієнтів, тож парний: t(7) ≈ 5,20, p ≈ 0,001».
- Не так«Ми спробували обидва критерії й показуємо значущий».
Критерій обирає дизайн ще до того, як ти бачиш p-значення.
Чотири інструменти для парних даних
Для парних даних є свій невеликий набір інструментів:
- залежні (парні) вибірки: вимірювання, що утворюють пари, зазвичай ті самі одиниці, виміряні двічі. Це дизайн, а не критерій;
- t-критерій для залежних вибірок (t-критерій Стьюдента для залежних вибірок): перевіряє, чи дорівнює нулю середнє різниць, t = d̄ / (s_d / √n), з n − 1 ступенями свободи. Для даних програми лояльності t ≈ 5,20 при df = 7, значно більше за критичне 2,365, тож p ≈ 0,001;
- критерій знаків: рахує, скільки різниць додатні, а скільки від'ємні, ігноруючи розмір;
- T-критерій Вілкоксона: ранжує модулі різниць і порівнює суми рангів додатних і від'ємних.
t-критерій — параметричний варіант: найпотужніший, коли різниці приблизно нормальні. Два інші — непараметричні запасні варіанти, що обмінюють трохи потужності на менше припущень.
І застереження, якого не виправить жоден критерій: дані «до/після» без контрольної групи не відокремлюють програму від усього іншого, що змінилося за той самий місяць, як-от сезон чи зміна цін.
- Так«t-критерій для залежних вибірок: t(7) = 5,20, p ≈ 0,001. Контрольної групи немає, тож сезонність — застереження».
- Не так«Критерій для залежних вибірок доводить, що зростання спричинила програма лояльності».
Він показує, що зміна реальна, але не що її спричинило.
Критерій знаків: рахуємо плюси й мінуси
Критерій знаків — найпростіший критерій для парних даних. Він відкидає розмір кожної різниці й залишає лише її напрям.
Логіка така: якщо зміна нічого не дала, різниця кожного клієнта з однаковою ймовірністю додатна чи від'ємна, як чесна монета. Тож кількість плюсів підкоряється розподілу підкидань монети, і питання в тому, наскільки незвичайна спостережена кількість.
Для даних програми лояльності всі 8 різниць додатні. Імовірність 8 орлів із 8 чесних підкидань — 0,5⁸ = 1 / 256 ≈ 0,39%. Двобічний критерій враховує ще й «усі від'ємні», тож p ≈ 0,78%. Значуще на рівні 5%.
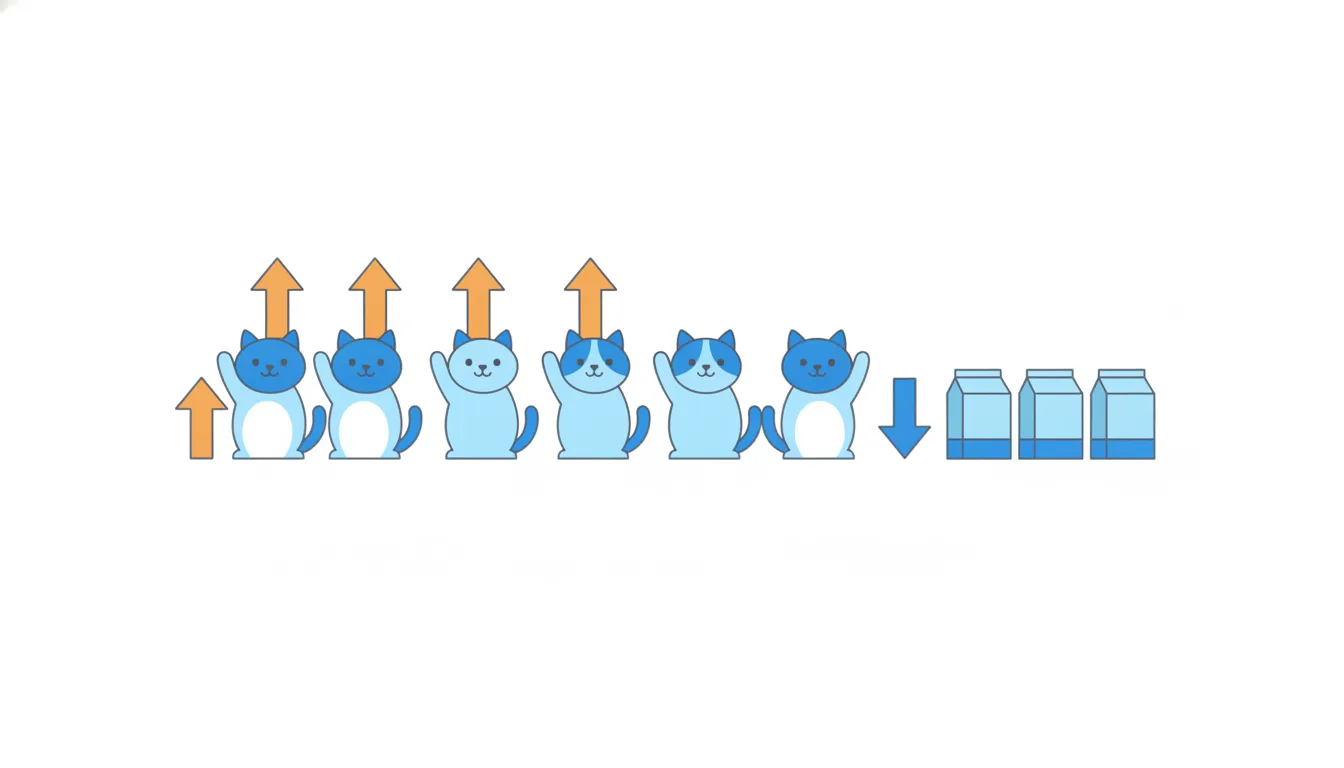
Різниці, рівні нулю, не мають напряму, і їх зазвичай відкидають, що зменшує n.
Коли його застосовувати: коли довіряти можна лише напряму або коли одна-дві екстремальні різниці домінували б у будь-якому критерії, що враховує розміри. Якщо різниці +1, +1, +2, 0, +1 і +9, то +9 тут нічого не роздуває: це просто ще один плюс.
Ціна — потужність. За малої кількості пар критерію знаків потрібні майже одностайні результати; для 5 пар навіть 5 із 5 дає двобічне p 0,0625.
- Так0,5⁸ = 1 / 256 ≈ 0,39% (однобічне)
- Не так0,5 × 8 = 4 → «шанс 50%»
Незалежні ймовірності множать, а не додають.
Як обрати між t-критерієм для залежних вибірок, Вілкоксоном і критерієм знаків
Усі три критерії відповідають на запитання «чи змістилися значення?» за тією самою колонкою різниць. Вони різняться тим, яку частину кожної різниці використовують.
- t-критерій для залежних вибірок: використовує точний розмір кожної різниці. Найпотужніший, але припускає, що різниці приблизно нормальні. З n − 1 ступенями свободи (7 для 8 пар).
- T-критерій Вілкоксона: використовує ранги модулів різниць і їхні знаки. Одна екстремальна різниця стає просто «найбільшим рангом», тож він значно безпечніший за асиметрії чи викидів і втрачає мало потужності.
- Критерій знаків: використовує лише напрям, плюс чи мінус. Дуже стійкий і найменш потужний.
Практичний порядок: спершу подивися на різниці. Приблизно симетричні, без диких значень — t-критерій для залежних вибірок. Кілька екстремальних різниць або крихітна вибірка — Вілкоксон. Довіряти можна лише напряму (оцінки, розміри яких можуть бути непорівнянні) — критерій знаків.
Хоч який критерій обереш, більшу частину потужності дає саме парування. Воно зазвичай дозволяє виявити той самий ефект на меншій кількості людей, ніж потрібно двом незалежним групам.
- ТакРізниці +1, +1, +2, 0, +1, +9 при n = 6: Вілкоксон або критерій знаків, а не t-критерій на сирих оцінках.
- Не так«Критерій знаків найбезпечніший, тож завжди беремо його».
Безпека коштує потужності; на чистих даних він викидає інформацію.
Готові потренуватися?
Виконайте вправи уроку й отримайте 250 балів, коли пройдете його вперше.
Розпочати вправи