

Теорія
Кластеризація для сегментації клієнтів
Сегментація клієнтів за даними: як дати кластерному аналізу підказати сегменти замість того, щоб їх вгадувати.
~10 хв читання · 11 вправ · 250 балів
Перед початком
Сегменти з даних
Ти й далі в продуктовій команді Котокорму, і маркетинг підкинув тобі новий запит: сегменти клієнтів. Найшвидший варіант — вгадати три групи, скажімо, ощадливих, постійних і щедрих покупців, і вважати справу зробленою.
У цьому уроці ти натомість даси даним самим підказати групи: чим кластерний аналіз відрізняється від класифікації, як виміряти схожість двох покупців і як працюють поширені методи кластеризації.
Кластеризація і класифікація
Обидва методи розкладають клієнтів по групах, але стартують із протилежних точок.
- Класифікація починає з відомих, названих груп. Є минулі клієнти з мітками «пішов» чи «активний», і треба прогнозувати мітку для нових. Модель вчиться на позначених прикладах; логістична регресія — один із таких інструментів. Її можна перевірити за справжніми мітками.
- Кластерний аналіз (кластеризація) починає зовсім без міток. Ти не знаєш, які є групи і навіть скільки їх. Метод збирає схожих клієнтів разом і дає групам проступити з даних. «Правильної відповіді» для перевірки немає; результат оцінюють за тим, чи групи відмінні, стабільні й корисні.
Швидка перевірка: чи є в даних колонка, яка вже каже, до якої групи належить кожен клієнт? Якщо так і її треба прогнозувати — це класифікація. Якщо ні і треба відкрити структуру — кластеризація.
Ці методи часто працюють разом. Сегментація може за допомогою кластеризації знайти чотири типи клієнтів, а потім класифікатором відносити кожну нову реєстрацію до одного з них.
- ТакМітки «пішов / активний» є → класифікація.
- Не так«У нас є мітки відтоку, тож кластеризуймо клієнтів, щоб прогнозувати відтік.»
Кластеризація ігнорує мітки, які вже є.
Відоме k чи невідоме
Перше запитання в будь-якому проєкті кластеризації: чи знаєш ти вже, скільки груп потрібно? Відповідь обирає метод.
- Кількість груп невідома → ієрархічна кластеризація. Вона не просить числа наперед. Вона крок за кроком об'єднує клієнтів і записує всю історію як дерево, тож спершу можна подивитися на структуру, а вже потім вирішити, скільки груп має сенс.
- Кількість груп відома → метод k-середніх. Якщо керівництво хоче рівно два сегменти за витратами чи маркетинг може провести рівно три кампанії, ти задаєш k, і метод знаходить найкращий поділ саме на стільки груп.
Вони різняться й масштабом. Ієрархічна кластеризація порівнює кожну пару клієнтів, тож пасує до сотень чи кількох тисяч записів і чудова для дослідження. Метод k-середніх швидкий і на сотнях тисяч, тому команди часто досліджують вибірку ієрархічно, а тоді запускають k-середні на всіх клієнтах з обраним k.
До жодної з ситуацій не пасують методи, що прогнозують відому мітку (як логістична регресія) чи порівнюють середні груп (як t-критерій). Вони відповідають на інші запитання.
- Так«Не знаю, скільки сегментів → почати з ієрархічної кластеризації й подивитися на дерево.»
- Не так«Не знаю, скільки сегментів → k-середні з k = 3, бо три звучить правильно.»
Задає k навмання.
Відстань: схожість як число
Кластеризації потрібна метрика відстані: правило, що перетворює «наскільки схожі ці два клієнти?» на число. Кожен клієнт — точка в просторі своїх метрик, тут (щомісячні витрати, замовлення на місяць).
- Евклідова відстань: пряма між двома точками. Підніс кожну різницю до квадрата, додай, візьми корінь: d = √Σ(x − y)². Для A(100, 1) і B(120, 1): √(20² + 0²) = √400 = 20.
- Мангеттенська відстань: іди вздовж сітки, а не навскіс. Додай модулі різниць: |120 − 100| + |1 − 1| = 20. Оскільки нічого не підносять до квадрата, одна велика різниця важить менше, ніж в евклідовій відстані.
- Відстань Чебишова: враховується лише одна найбільша різниця серед усіх змінних.
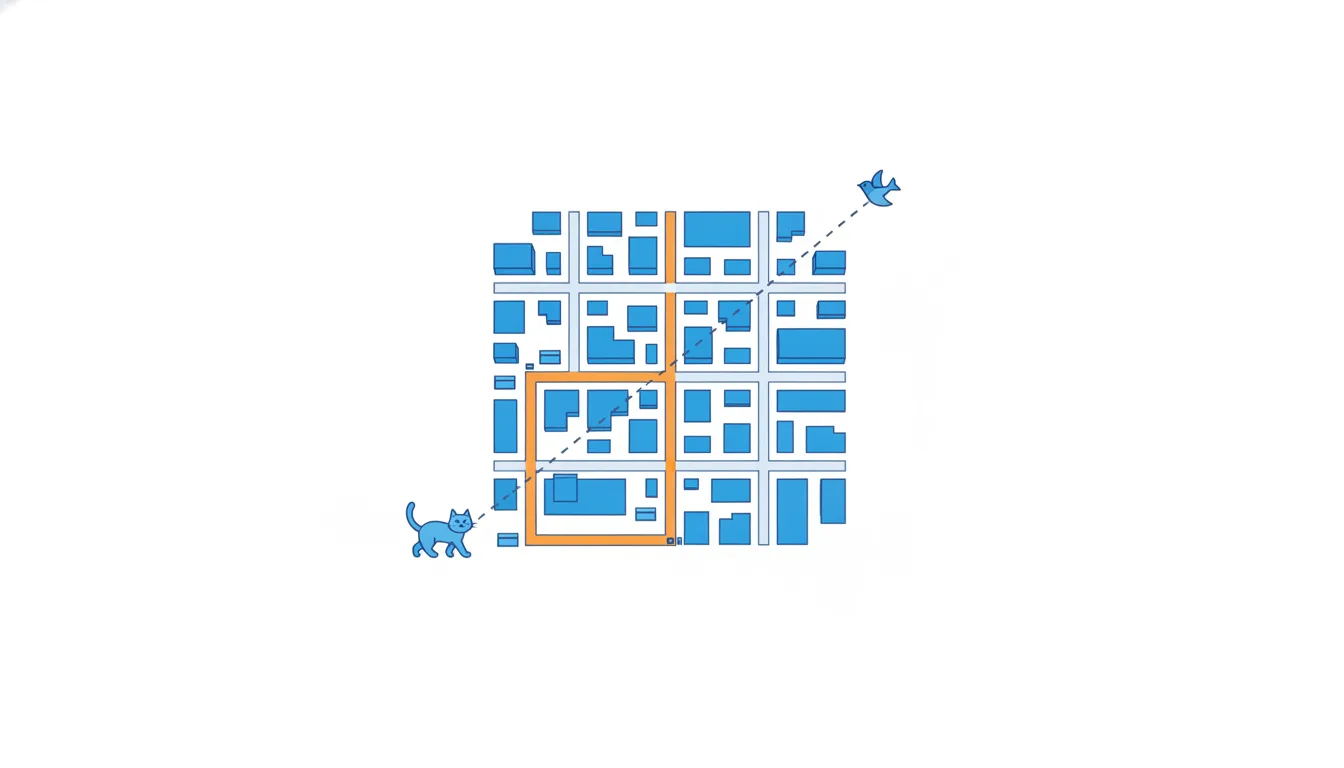
Для A і B усі три дають 20, бо клієнти відрізняються лише однією змінною. Розходяться метрики тоді, коли клієнти відрізняються кількома.
Типові помилки: забути корінь в евклідовій відстані (тут вийшло б 400) або додавати різниці зі знаками, так що +20 і −20 скоротяться до нуля. Відстань ніколи не буває від'ємною.
- Так√((120 − 100)² + (1 − 1)²) = √400 = 20
- Не так(120 − 100)² + (1 − 1)² = 400
Забуто корінь.
Ієрархічна кластеризація і дендрограма
Ієрархічна кластеризація будує групи знизу вгору:
- Спершу кожен клієнт — окремий кластер.
- Знайди два найближчі кластери й об'єднай їх.
- Перерахуй відстані між новим кластером та рештою.
- Повторюй, доки всі не опиняться в одному великому кластері.
Кожне об'єднання записується в дендрограму: перевернуте дерево з клієнтами на листках. Висота, на якій з'єднуються дві гілки, показує, наскільки далекими вони були в момент об'єднання. Низькі з'єднання означають дуже схожих клієнтів; високі — що методу довелося долати великий розрив.
Щоб отримати сегменти, розітни дерево горизонтальною лінією. Кожна гілка, яку вона перетинає, стає одним кластером. Розріж низько — отримаєш багато дрібних щільних груп; високо — кілька широких. Природне місце для розрізу — трохи нижче найвищих з'єднань, де об'єднувані групи були явно різними.
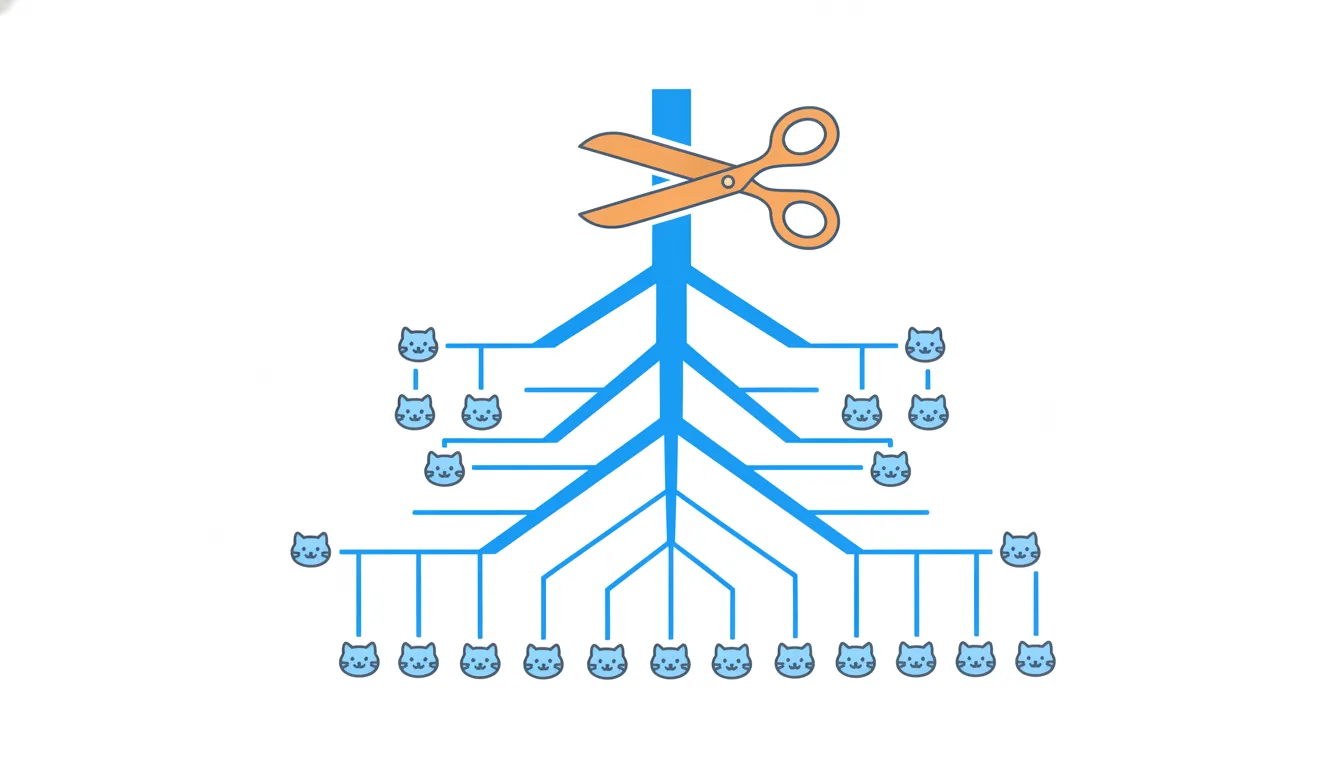
Дендрограма — головна перевага методу: бачиш усі можливі групування одразу й обираєш кількість потім. Слабке місце — розмір: порівняння кожної пари сповільнюється на дуже великій кількості клієнтів, а раннє об'єднання потім не скасувати.
- ТакРозітнути дендрограму трохи нижче найвищих з'єднань → кілька явно різних сегментів.
- Не такРозрізати одразу над листками й звітувати про 40 «сегментів».
Групи з одного-двох клієнтів — не сегменти, з якими можна працювати.
Центроїд
У методі k-середніх кожен кластер представляє його центроїд: точка, координати якої — середнє всіх учасників за кожною змінною.
Для кластера з двох клієнтів із координатами (щомісячні витрати в грн, замовлення на місяць) C(500, 5) і D(520, 5):
- витрати: (500 + 520) / 2 = 510 грн;
- замовлення: (5 + 5) / 2 = 5.
Отже, центроїд — (510, 5). Зверни увагу: жоден реальний клієнт там не стоїть, центроїд — це обчислена точка, а не учасник. Для трьох клієнтів із витратами 300, 400 і 800 грн витрати центроїда були б 500, тобто значенням, якого немає ні в кого з них.
Саме тому він корисний як профіль сегмента. «Великі покупці: у середньому близько 510 грн і 5 замовлень на місяць» — так описують кластер маркетингу. Два застереження:
- окремі клієнти розкидані навколо центроїда; наводь і розкид чи діапазон, а не лише середнє;
- як будь-яке середнє, центроїд тягнуть викиди. Один клієнт, що витрачає 10 000 грн, може відтягнути центроїд далеко від більшості учасників.
Типова помилка — усереднити не ті значення, наприклад домішати учасників іншого кластера або усереднити витрати й замовлення разом в одне число.
- ТакЦентроїд {C, D}: ((500 + 520) / 2, (5 + 5) / 2) = (510, 5)
- Не так«Центроїд — це клієнт D, найближчий до середини.»
Центроїд — обчислене середнє, а не учасник.
Як працює метод k-середніх
Метод k-середніх ділить клієнтів на обрану кількість груп, k, повторюючи два прості кроки.
- Старт: розмісти k центроїдів у довільних позиціях, часто на k випадково обраних клієнтах.
- Вимір: обчисли відстань від кожного клієнта до кожного центроїда.
- Призначення: віднеси кожного клієнта до кластера найближчого центроїда.
- Оновлення: перемісти кожен центроїд у середнє клієнтів, яких йому тепер призначено.
- Повторюй кроки 2–4, доки жоден клієнт не змінить кластер і центроїди не перестануть рухатися. Це збіжність.
Для чотирьох клієнтів із координатами (щомісячні витрати в грн, замовлення на місяць) A(100, 1), B(120, 1), C(500, 5), D(520, 5) і k = 2 метод стабілізується за крок-два: A і B в одному кластері з центроїдом (110, 1), C і D в іншому з (510, 5).
Дані графіка
| Щомісячні витрати, грн | Невеликі витрати (A, B) | Великі витрати (C, D) |
|---|---|---|
| 100 | 1 | |
| 120 | 1 | |
| 500 | 5 | |
| 520 | 5 |
Порядок важливий. Якщо рухати центроїди до призначення клієнтів, нема чого усереднювати; якщо зупинитися після одного проходу, клієнти можуть лишитися прив'язаними до центроїда, який уже від них відійшов.
Метод k-середніх завжди збігається, але не завжди до найкращого поділу: невдалий старт може загнати його в гірше групування. Тому його запускають кілька разів із різних стартових точок і лишають найстабільніший результат.
- ТакРозмістити → виміряти → призначити → оновити → повторювати, доки ніщо не рухається.
- Не такЗробити один прохід «призначити й оновити» і звітувати про кластери.
Зупиняється до збіжності.
Коли одна змінна захоплює відстань
Відстані підсумовують сирі різниці, тож непомітно віддають перевагу тій змінній, у якої числа більші.
Візьми A(100 грн, 1 замовлення) і C(500 грн, 5 замовлень):
d = √((500 − 100)² + (5 − 1)²) = √(160 000 + 16) = √160 016 ≈ 400,02.
Формула: Евклідова відстань: відстань по прямій за всіма змінними. · є вище
Розрив у 400 грн витрат дає 160 000; розрив у 4 замовлення на місяць, а це велика різниця в поведінці, — 16. Замовлення зсувають відстань на 0,02. На сирих значеннях кластеризація фактично групує лише за витратами.
Ще гірше з довільним вибором одиниць. Вимірюй витрати в тисячах гривень (0,1 і 0,5) — і раптом домінують замовлення. Клієнти не змінилися, а кластери можуть змінитися.
Характерна ознака на практиці: кластери, що акуратно вишикувалися вздовж однієї змінної й ігнорують інші. Перш ніж вирішити, що інші змінні «не важливі», перевір їхній масштаб.
Виправлення — стандартизація: звести кожну змінну до спільного масштабу перед будь-яким обчисленням відстані.
- Так√(400² + 4²) ≈ 400,02: на сирих значеннях замовлення майже нічого не додають.
- Не так«Наші кластери діляться лише за витратами, отже, частота замовлень для сегментів не важлива.»
Це вирішив масштаб, а не бізнес.
Стандартизуй перед кластеризацією
Стандартизація (масштабування) ставить усі змінні в однакові умови перед обчисленням відстаней. Звичайний спосіб — перевести кожне значення в z-оцінку:
z = (значення − середнє змінної) / стандартне відхилення змінної
Після цього кожна змінна має середнє 0 і стандартне відхилення 1. Клієнт, у якого витрати на одне стандартне відхилення вищі за середнє і замовлення теж на одне вищі, тепер «однаково незвичний» за обома, хай якими були початкові одиниці.
Для чотирьох клієнтів із (витрати, замовлення) A(100, 1), B(120, 1), C(500, 5) і D(520, 5) середні витрати — 310 грн, стандартне відхилення — близько 231; середнє замовлень — 3, стандартне відхилення — близько 2,3. z-оцінки A: (100 − 310) / 231 ≈ −0,91 для витрат і (1 − 3) / 2,3 ≈ −0,87 для замовлень: тепер обидві змінні важать у відстані приблизно однаково.
Стандартизуй кожну змінну, що входить у відстань, на тих самих клієнтах, яких кластеризуєш. І пам'ятай, що це означає: ти кажеш методу, що всі змінні однаково важливі. Якщо для бізнесу одна змінна важливіша, дай їй більшу вагу свідомо, а не залишай це на розсуд одиниць виміру.
- ТакПеревести витрати й замовлення в z-оцінки, а тоді запустити k-середні.
- Не такЗапустити k-середні на витратах у гривнях і замовленнях на місяць як є.
Великі числа витрат заглушують замовлення.
Як обрати k і перевірити стабільність
Три перевірки перетворюють запуск методу k-середніх на сегменти, яким маркетинг може довіряти.
- Обирай k за судженням і за даними. Почни з бізнесу: зі скількома сегментами команда реально працюватиме по-різному? Потім побудуй похибку кластеризації (сумарну відстань від клієнтів до їхніх центроїдів) для k = 1, 2, 3, …. Похибка завжди падає зі зростанням k, тож шукай точку, де спад вирівнюється; далі нові кластери лише дроблять справжні групи на шматки.
- Стандартизуй кожну змінну заздалегідь, щоб результат не вирішували одиниці виміру.
- Запусти кілька разів із різних стартових центроїдів. Якщо щоразу повертаються ті самі групи, структура справжня. Якщо вони перетасовуються за кожного запуску, k, імовірно, хибне або в даних немає чітких груп.
Потім перевір самі сегменти на здоровий глузд: чи кожен достатньо великий, щоб на нього діяти, і чи можна описати кожен одним реченням за його центроїдом?
Спокуслива помилка — дуже велике k «для більшої персоналізації». У крайньому випадку кожен клієнт отримує власний кластер: ідеальне прилягання, нуль розуміння. Сегментація корисна саме тому, що спрощує.
- Такk = 3: крива похибки там вирівнюється, групи повторюються в 10 запусках, а маркетинг може провести 3 кампанії.
- Не так«k = 6, бо більше сегментів — більше персоналізації.»
Крихітні нестабільні сегменти нікому не допомагають.
Готові потренуватися?
Виконайте вправи уроку й отримайте 250 балів, коли пройдете його вперше.
Розпочати вправи