

Теорія
Підсумок курсу: як обрати правильний критерій
Шпаргалка для вибору методу, що поєднує весь курс.
~11 хв читання · 12 вправ · 250 балів
Перед початком
Одна мапа на весь курс
Останній урок. Після цілого курсу відповідей на запитання продуктової команди Котокорму про дані ти знаєш із десяток методів, і легко заплутатися, який із них для чого.
Цей урок зводить їх в одну схему вибору: два запитання про твої дані, які вказують на потрібний критерій, — чи то ти порівнюєш групи, шукаєш зв'язки, робиш прогнози, чи працюєш з даними, де взагалі немає цільової змінної.
Два запитання за кожним критерієм
Майже кожен метод цього курсу обирають, відповівши на два запитання.
- Що я порівнюю? Типове значення однієї змінної, дві групи, три й більше груп, зв'язок між змінними чи групи, яких ще ніхто не визначив.
- Чи задовольняють дані припущення параметричного критерію? Параметричний критерій, як-от t-критерій чи дисперсійний аналіз, порівнює середні й спирається на приблизно нормальні дані (або велику вибірку), відсутність екстремальних викидів і достатній обсяг вибірки. Якщо ні, бери його непараметричного двійника, що працює з рангами замість сирих значень.
Для двох незалежних груп:
- приблизно нормальні дані, достатнє n → t-критерій Стьюдента для незалежних вибірок (або t-критерій Велча, якщо розкиди різні);
- скошені дані, малі вибірки чи екстремальні викиди → U-критерій Манна-Вітні.
Час на сторінці для 15 користувачів у варіанті, сильно скошений із кількома крайніми значеннями, — хрестоматійний випадок для Манна-Вітні: дві екстремальні сесії можуть розхитати обидва середні, а рангам важливий лише порядок.
Ціна непараметричного шляху — трохи менша потужність, коли дані насправді нормальні, тому він не є вибором за замовчуванням для всього.
- Так15 проти 15 користувачів, сильна асиметрія, екстремальні викиди → U-критерій Манна-Вітні.
- Не так«Дві групи — отже, t-критерій», не глянувши на форму даних.
Відповідає лише на перше з двох запитань.
Незалежні чи залежні вибірки
Перш ніж обирати критерій для двох наборів чисел, запитай: це різні люди чи ті самі, виміряні двічі?
- Незалежні вибірки: у кожній групі різні користувачі, як в A/B-тесті, де кожен відвідувач бачить лише один варіант. Бери t-критерій Стьюдента для незалежних вибірок або U-критерій Манна-Вітні.
- Залежні (парні) вибірки: ті самі користувачі до і після зміни або ті самі магазини цього й минулого місяця. Кожне значення має природну пару.
Для парних даних працюй із різницями всередині кожної пари:
- різниці приблизно нормальні → t-критерій Стьюдента для залежних вибірок (парний t-критерій);
- різниці скошені чи з викидами → T-критерій Вілкоксона.
Чому це важливо: люди сильно відрізняються одне від одного, але значно менше — від самих себе. Парний критерій прибирає різницю між людьми й порівнює кожного користувача лише з його власною попередньою оцінкою, тож помічає меншу зміну на тих самих 40 користувачах. Якщо вважати парні дані незалежними, ця перевага зникає.
Та сама логіка поширюється на три й більше вимірювань тих самих людей: дисперсійний аналіз із повторними вимірюваннями або критерій Фрідмана для скошених даних.
- ТакТі самі 40 користувачів до і після → парний t-критерій на різницях.
- Не такТі самі 40 користувачів до і після → t-критерій для незалежних вибірок.
Ігнорує пари й втрачає потужність.
Похибка оцінки
Хай який критерій ти запускаєш, сама оцінка потребує міри точності. Похибка оцінки (гранична похибка) каже, наскільки далеко справжнє значення правдоподібно може бути від твоєї оцінки. Коли довірчий рівень — 95%, вона приблизно дорівнює
похибка оцінки ≈ 1,96 × СП
де СП — стандартна похибка оцінки: наскільки вона коливалася б від вибірки до вибірки.
Якщо оцінка конверсії Котокорму має стандартну похибку 1,2 відсоткового пункту:
1,96 × 1,2 = 2,352 ≈ 2,35 відсоткового пункту.
Звідки 1,96? У нормальному розподілі 95% значень лежать у межах 1,96 стандартного відхилення від середнього. Грубе правило «2 стандартні похибки» — та сама ідея, округлена.
Дві помилки, яких варто уникати:
- брати стандартне відхилення окремих значень замість стандартної похибки. СВ описує, як різняться окремі користувачі; СП — як коливається оцінка, і вона значно менша;
- забувати про одиниці. Для частки похибка вимірюється у відсоткових пунктах, а не у відсотках від частки: ±2,35 пункту навколо 12% — це від 9,65% до 14,35%, а не 12% ± 2,35% від 12%.
- Так1,96 × 1,2 в. п. ≈ 2,35 відсоткового пункту
- Не так1,2 / 1,96 ≈ 0,61 відсоткового пункту
Ділить замість множити, тож інтервал виходить надто вузьким.
Від похибки оцінки до довірчого інтервалу
Довірчий інтервал (ДІ) — це оцінка з похибкою оцінки по обидва боки:
ДІ = оцінка ± похибка оцінки
Для оцінки конверсії 12,0% і похибки 2,35 відсоткового пункту:
- нижня межа: 12,0 − 2,35 = 9,65%;
- верхня межа: 12,0 + 2,35 = 14,35%.
Як це читати: якби те саме дослідження повторили багато разів, приблизно 95% інтервалів, побудованих так, містили б справжню конверсію. На практиці сприймай 9,65–14,35% як діапазон значень, з якими сумісні дані. Це не діапазон, куди потрапляють 95% окремих користувачів, і він не робить усі значення всередині однаково ймовірними: значення біля 12% підтримані краще, ніж біля країв.
Навіщо подавати інтервал, а не лише p-значення? Він показує і ефект, і його невизначеність в одиницях самої метрики. Інтервал приросту від +0,1 до +4 пунктів каже «імовірно, додатний, розмір дуже невизначений»; від +1,8 до +2,2 — «явно додатний і добре виміряний».
Типові помилки: відняти похибку двічі або додати похибку у відсотках від частки до частки у відсоткових пунктах.
- Так12,0% ± 2,35 в. п. → 95% ДІ від 9,65% до 14,35%
- Не так«95% наших відвідувачів конвертуються з імовірністю від 9,65% до 14,35%.»
ДІ описує оцінку, а не окремих користувачів.
Зв'язки і прогнози
Коли питання про те, як пов'язані змінні, а не як різняться групи, метод залежить від мети і від типу результату.
- Як дві метрики рухаються разом? → кореляція: r Пірсона для приблизно лінійних симетричних даних; ρ Спірмена для скошених даних, викидів чи рангів. Вона описує, а не прогнозує.
- Прогнозувати число за одним чи кількома предикторами? → лінійна регресія: проста з одним предиктором, множинна з кількома. Замовлення за рекламними витратами, виручка за ціною і сезоном.
- Прогнозувати результат «так/ні»? → логістична регресія: вона моделює ймовірність «так», завжди між 0 і 1. Чи піде цей клієнт, чи купить цей відвідувач.
- Відносити нові випадки до відомих груп? → класифікація, і логістична регресія з порогом — один із її прикладів.
Тип результату — швидкий фільтр: неперервне число вказує на лінійну регресію, «так/ні» — на логістичну. Пряма для відтоку дає «ймовірності» на кшталт 1,3; логістична регресія для виручки не має сенсу.
І для всіх них: зв'язок у минулих даних не доводить причинності. Якщо рішення залежить від причини, плануй експеримент.
- ТакЧи піде цей клієнт наступного місяця? → логістична регресія.
- Не такВідтік 0/1 → лінійна регресія → «ймовірність відтоку 1,3».
Результату «так/ні» потрібна модель, обмежена 0 і 1.
Коли результату немає взагалі
Деякі запитання не мають цільової змінної: ніхто не прогнозує відтік і не порівнює варіанти, треба просто побачити структуру. Для цього є два методи, і різниця в тому, що групують.
- Групувати спостереження (клієнтів, магазини, сесії) → кластерний аналіз. Клієнти зі схожими витратами й частотою замовлень потрапляють в один сегмент.
- Невідомо, скільки груп → ієрархічна кластеризація, далі розтин дендрограми там, де гілки високі.
- Кількість відома → метод k-середніх, з k, заданим наперед за потребами бізнесу й кривою похибки від k.
- Групувати змінні (запитання опитування, метрики) → факторний аналіз. Двадцять корельованих запитань стають кількома латентними темами, як-от лояльність до бренду і якість доставки.
Для обох діє та сама гігієна: стандартизуй змінні з різними шкалами, перевір стабільність результату (перезапусти k-середні з різних стартів; для факторів перевір осип і критерій Кайзера) і переконайся, що кожну групу чи фактор можна описати простими словами.
Жоден із методів не перевіряє гіпотез. Вони описують структуру наявних даних, і їхній результат — відправна точка для рішень, а не доказ.
- ТакНевідома кількість сегментів → ієрархічна кластеризація, розтин дерева потім.
- Не такНевідома кількість сегментів → k-середні з k «на відчуття».
Методу k-середніх потрібне k ще до запуску.
Карта методів
Поєднай два запитання — і більшість ситуацій розкладеться сама:
- 2 незалежні групи, середнє: приблизно нормальні дані → t-критерій Стьюдента; скошені чи з викидами → U-критерій Манна-Вітні.
- Ті самі об'єкти до і після: парний t-критерій або T-критерій Вілкоксона для скошених різниць.
- 3+ незалежні групи, середнє: приблизно нормальні → однофакторний дисперсійний аналіз (ANOVA); скошені → H-критерій Краскела-Уолліса. Далі апостеріорний критерій, наприклад критерій Тьюкі (HSD), щоб побачити, які групи відрізняються.
- Частки (конверсія, клікабельність): два варіанти → z-критерій для двох часток; кілька варіантів → критерій хі-квадрат Пірсона для таблиці спряженості «варіант × сконвертувався / ні».
- Зв'язок двох метрик → кореляція; прогноз однієї → регресія.
- Без міток: групувати клієнтів → кластерний аналіз; групувати запитання → факторний аналіз.
Найчастіше помиляються з частками для 3+ варіантів. Схоже на задачу для ANOVA, бо груп кілька, але ANOVA порівнює середні неперервної змінної. Конверсія — це «так/ні» для кожного відвідувача, тож правильний інструмент — хі-квадрат.
Питай «це середнє чи частка?» одразу після «скільки груп?».
- ТакКонверсія трьох лендингів → хі-квадрат для таблиці 3 × 2.
- Не такКонверсія трьох лендингів → однофакторний дисперсійний аналіз.
ANOVA порівнює середні неперервної змінної, а не частки.
Статистична і практична значущість
p-значення відповідає на одне вузьке запитання: якби справжнього ефекту не було, наскільки дивними були б такі дані? Мале p означає «імовірно, не просто шум». Про те, чи ефект достатньо великий, щоб мати значення, воно не каже нічого.
На величезних вибірках статистично значущими стають крихітні ефекти. A/B-тест на 2 мільйонах користувачів може показати зростання конверсії з 5,0% до 5,1% за p = 0,01. Це статистична значущість. Чи є тут практична значущість, залежить від бізнесу:
- абсолютний приріст — 0,1 відсоткового пункту, відносний — 0,1 / 5,0 = 2%;
- чи варте це витрат на розробку, дизайн і підтримку зміни?
- чи весь довірчий інтервал вищий за найменший приріст, який тебе цікавить, чи він сягає майже нуля?
Буває й навпаки: малий тест може показати великий цінний ефект за p = 0,12. Це не «ефекту немає», а «даних замало, щоб бути певним».
Подавай обидва: розмір ефекту з довірчим інтервалом і p-значення. Заздалегідь вирішуй, який приріст виправдав би зміну (мінімальний виявлюваний ефект, під який планували тест), і оцінюй результат відносно нього.
- Так«+0,1 в. п. (95% ДІ від +0,02 до +0,18), p = 0,01: справжній, але нижчий за наш поріг 0,3 в. п.»
- Не так«p = 0,01 — велика перемога.»
Мале p — не великий ефект.
Коли не довіряти значущому результату
Правильний вибір критерію на папері не захищає результат від того, як його отримано. Три тривожні ознаки означають, що «значущий» може мало що значити.
- Підглядання (передчасна зупинка). Якщо щодня перевіряти результат і зупинитися в перший день, коли p опуститься нижче 0,05, випадковість отримує багато спроб перетнути межу. Справжня частка хибнопозитивних результатів стає значно вищою за 5%. Фіксуй обсяг вибірки заздалегідь або використовуй послідовне тестування, розраховане на повторні перегляди.
- Множинні порівняння. Перевір 20 метрик за α = 0,05 — і очікуй приблизно один «значущий» результат від самого шуму (20 × 0,05 = 1). Звіт лише про нього — хибне відкриття. Заздалегідь назви одну основну метрику, а для решти застосуй поправку, наприклад поправку Бонферроні (0,05 / 20 = 0,0025 на кожну перевірку).
- Крихітний розмір ефекту. p < 0,05 за мізерного приросту — це статистична, але не практична значущість.
Одна ознака заспокоює, а не тривожить: результат підтверджується на новій вибірці (повторне дослідження чи окрема тестова вибірка). Це найсильніший повсякденний доказ, що ефект справжній.
- Так«Основну метрику зафіксовано заздалегідь; 19 додаткових перевірено з поправкою Бонферроні.»
- Не так«Ми відстежували 20 метрик; час на сторінці вийшов значущим, отже, редизайн працює.»
Одне влучання з 20 перевірок без поправки — саме те, що дає шум.
Дисциплінований порядок роботи
Найнадійніші аналізи щоразу йдуть тим самим порядком, і саме порядок тримає їх чесними.
- Запиши рішення й основну метрику до того, як глянеш на дані: що ти робитимеш, якщо метрика зросте, впаде чи не зміниться?
- Перевір форму і дизайн даних: незалежні чи парні? Середнє чи частка? Приблизно нормальні, скошені, викиди?
- Обери критерій чи модель за картою методів.
- Обчисли статистику критерію або побудуй модель.
- Інтерпретуй із практичною значущістю й захисними метриками: розмір ефекту й довірчий інтервал, а не лише p < 0,05, плюс перевірка, що захисні метрики (повернення, час доставки, відписки) не погіршилися.
Чому саме такий порядок? Якщо спершу глянути на результати, кортить спробувати t-критерій, потім Манна-Вітні, потім іншу метрику, доки щось не перетне 0,05. Такий підбір методу під результат — це прихована проблема множинних порівнянь: кожна додаткова спроба — ще один шанс для шуму видатися знахідкою.
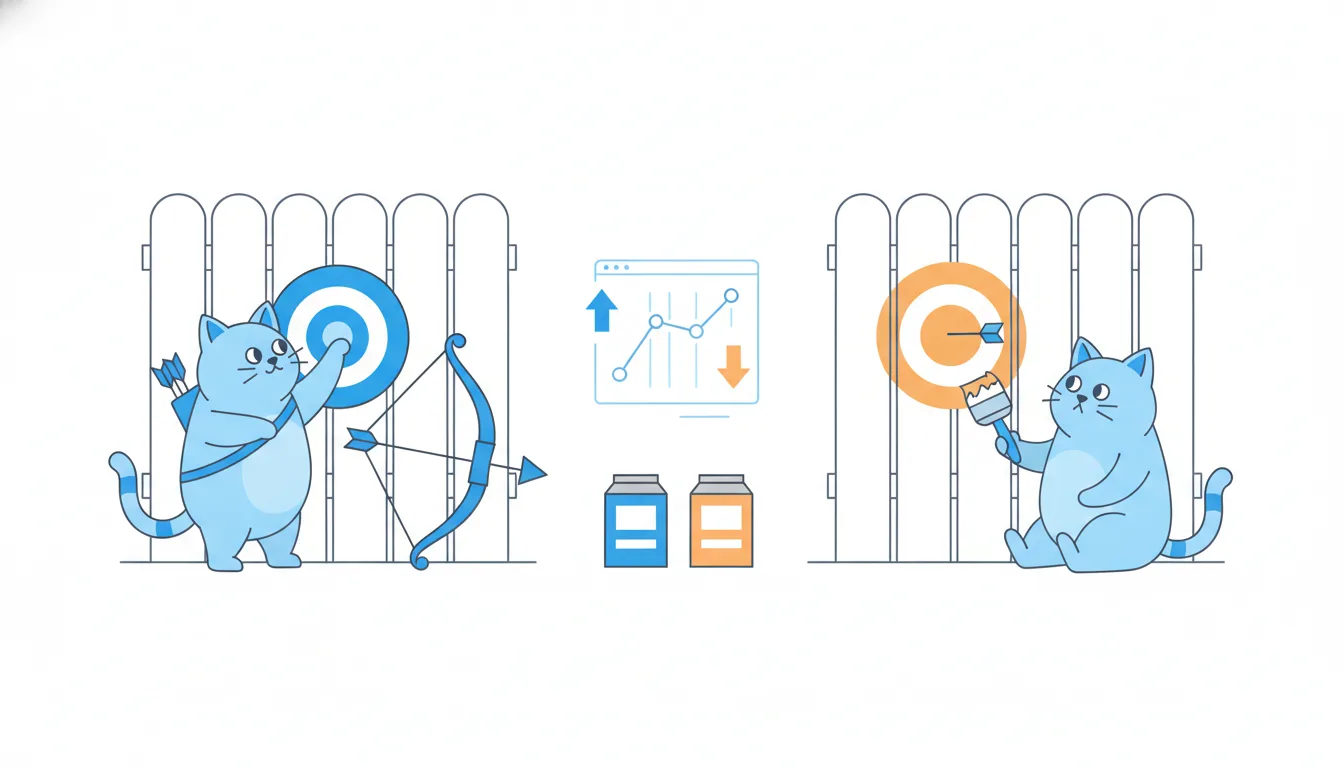
Кроки 2 і 3 залежать від форми даних, тож дивитися на гістограми перед вибором критерію — нормально. Першими мають іти запитання й метрика, а не відповідь, на яку сподіваєшся.
- ТакМетрику й рішення записано → форму перевірено → критерій обрано → обчислено → перевірено практичну значущість і захисні метрики.
- Не так«t-критерій дав p = 0,08, спробуймо Манна-Вітні й подивимося.»
Підбір методу після того, як побачили результат.
Готові потренуватися?
Виконайте вправи уроку й отримайте 250 балів, коли пройдете його вперше.
Розпочати вправи