

Теорія
Зміщення відбору: хто робить X, той краще утримується
Приклад зміщення відбору: кореляція, самовідбір, змішувальний фактор і що можуть, а чого не можуть сказати користувачі фічі.
~9 хв читання · 9 вправ · 250 балів
Перед початком
Ті, хто сканує, залишаються довше?
Maya помітила в даних Halves обнадійливу закономірність для презентації Plus: нові користувачі, які сканують чек у перший тиждень, значно частіше активні на четвертому тижні. Вона хоче просувати сканування в онбордингу, а Theo — написати про це на сторінці в магазині застосунків. Але спершу це потрапляє до тебе.
У цьому уроці ти дізнаєшся, коли «хто робить X, той краще утримується» — це кореляція, а коли причина, і що користувачі самої фічі можуть сказати, а що — ні.
Кореляція — це опис, причина — це твердження
«Користувачі, які роблять X, краще утримуються» — один із найпоширеніших слайдів у продуктовій аналітиці й один із тих, які найчастіше читають хибно.
Числа Maya правильні: нові користувачі, які сканували чек за перший тиждень, були активні на четвертому тижні в 49% випадків, усі інші — у 27%. Це кореляція: дві речі, що йдуть у даних разом. Вона описує те, що сталося.
«Сканування змушує людей лишатися» — твердження іншого роду: про причину. Воно передбачає, що станеться, якщо щось змінити, наприклад заохотити більше людей сканувати. Дані про те, хто випадково сканував, самі цього не покажуть, бо ті, хто сканує, можуть відрізнятися від інших і тим, що теж впливає на утримання.
Практична перевірка — дієслово. Описові дієслова («були активні», «краще утримувалися», «частіше») лишаються в межах даних. Причинні («підвищує», «рухає», «змушує», «піднімає») потребують доказу, що саме зміна дала різницю, а це зазвичай означає експеримент.
Лишай числа; прибирай стрілку від одного до іншого, доки щось її не заслужить.
- Так«Нові користувачі, які сканували за перший тиждень, були активні на четвертому тижні в 49% випадків, інші — у 27%.»
- Не так«Сканування чеків підвищує утримання на 22 пункти.»
Причинне дієслово для кореляції.
Як перерахувати головний розрив
Перш ніж сумніватися в твердженні, перевір, що його числа правильні. Датасет ділить нових користувачів (реєстрації квітня–травня, які додали хоча б одну витрату в дні 0–6) за тим, наскільки активними вони були на першому тижні і чи сканували чек.
Набір даних · 6 рядків
Сканування чеків і утримання на четвертому тижні
Нові користувачі Halves квітня–травня 2026 року, які додали хоча б одну витрату в дні 0–6.
Перші 5 з 6 рядків
Об'єднай кожну групу через усі групи активності, а потім поділи один раз:
- Ті, хто сканував: активні 9 + 49 + 184 = 242 із 57 + 133 + 303 = 493 користувачів, тобто 242 ÷ 493 = 49,09%.
- Ті, хто не сканував: 173 + 335 + 233 = 741 із 1343 + 967 + 397 = 2707, тобто 741 ÷ 2707 = 27,37%.
- Розрив: 49,09 − 27,37 = 21,71 п. п., з неокруглених часток.
Тож 49% проти 27% у Maya підтверджуються. Проблема ніколи не в арифметиці, а в тому, що цьому розриву приписують.
Дорогою варто помітити дві деталі. Ті, хто сканує, — мала група: 493 із 3200 користувачів, близько 15%. І рядки вже підказують наступний крок: користувачі, що сканують, зосереджені в найактивнішій групі. Об'єднаний підсумок ховає цей склад; рядки його показують.
- Так242 ÷ 493 − 741 ÷ 2707 = 49,09% − 27,37% = 21,71 п. п.
- Не такУсереднити три частки груп активності для кожної групи
Групи дуже різні за розміром; додавай кількості.
Самовідбір: подивися, хто в кожній групі
Ніхто не призначав користувачам сканувати. Вони обрали це самі, а ті, хто обирає функцію, рідко бувають випадковою вибіркою з усіх.
Хто сканує чеки в Halves? Безкоштовні користувачі мають три сканування на місяць, а сканує той, хто платить за вечері й продукти. Тож ті, хто сканує, зазвичай активні. Рядки це підтверджують: 303 із 493 тих, хто сканував (61,46%), додали п'ять чи більше витрат за перший тиждень проти 397 із 2707 тих, хто не сканував (14,67%).
Датасет: Сканування чеків і утримання на четвертому тижні · є вище
А активні користувачі краще утримуються, хоч би що вони робили з чеками: у групі 5_plus на четвертому тижні були активні приблизно 59–61%, у групі 1 — лише близько 13–16%.
Це зміщення відбору (selection bias), тут — самовідбір: групи відрізняються тим, хто в кожну потрапив, а не лише функцією. Розрив у 22 пункти порівнює групу, де переважно активні, з групою, де переважно малоактивні.
Звичка, яку варто виробити: щоразу, коли слайд порівнює «тих, хто зробив X» із «тими, хто ні», спершу спитай, чим ці групи відрізнялися ще до X. Якщо тим, що теж впливає на результат, сирий розрив змішує одне з іншим.
- ТакТі, хто сканував, у
5_plus: 303 ÷ 493 = 61,46%; ті, хто ні: 397 ÷ 2707 = 14,67% - Не так«Ті, хто сканує, і ті, хто ні, — однакові люди; одна група просто сканувала.»
Вони самі обрали сканувати, а обирають активні.
Змішувальний фактор і порівняння всередині нього
Активність першого тижня — змішувальний фактор (confounding variable): вона впливає і на «причину» (активні частіше сканують), і на результат (активні краще утримуються). Змішувальний фактор може створити розрив між групами, навіть якщо сама функція нічого не робить.
Перше виправлення — порівнювати всередині фактора: тих, хто сканував, з тими, хто ні, але був так само активним.
5_plus: 184 ÷ 303 = 60,73% проти 233 ÷ 397 = 58,69%, +2,04 п. п.;2_to_4: 36,84% проти 34,64%, +2,20 п. п.;1: 15,79% проти 12,88%, +2,91 п. п.
Датасет: Сканування чеків і утримання на четвертому тижні · є вище
Два-три пункти в кожній групі, а не 22. Більшу частину головного розриву дав змішувальний фактор.
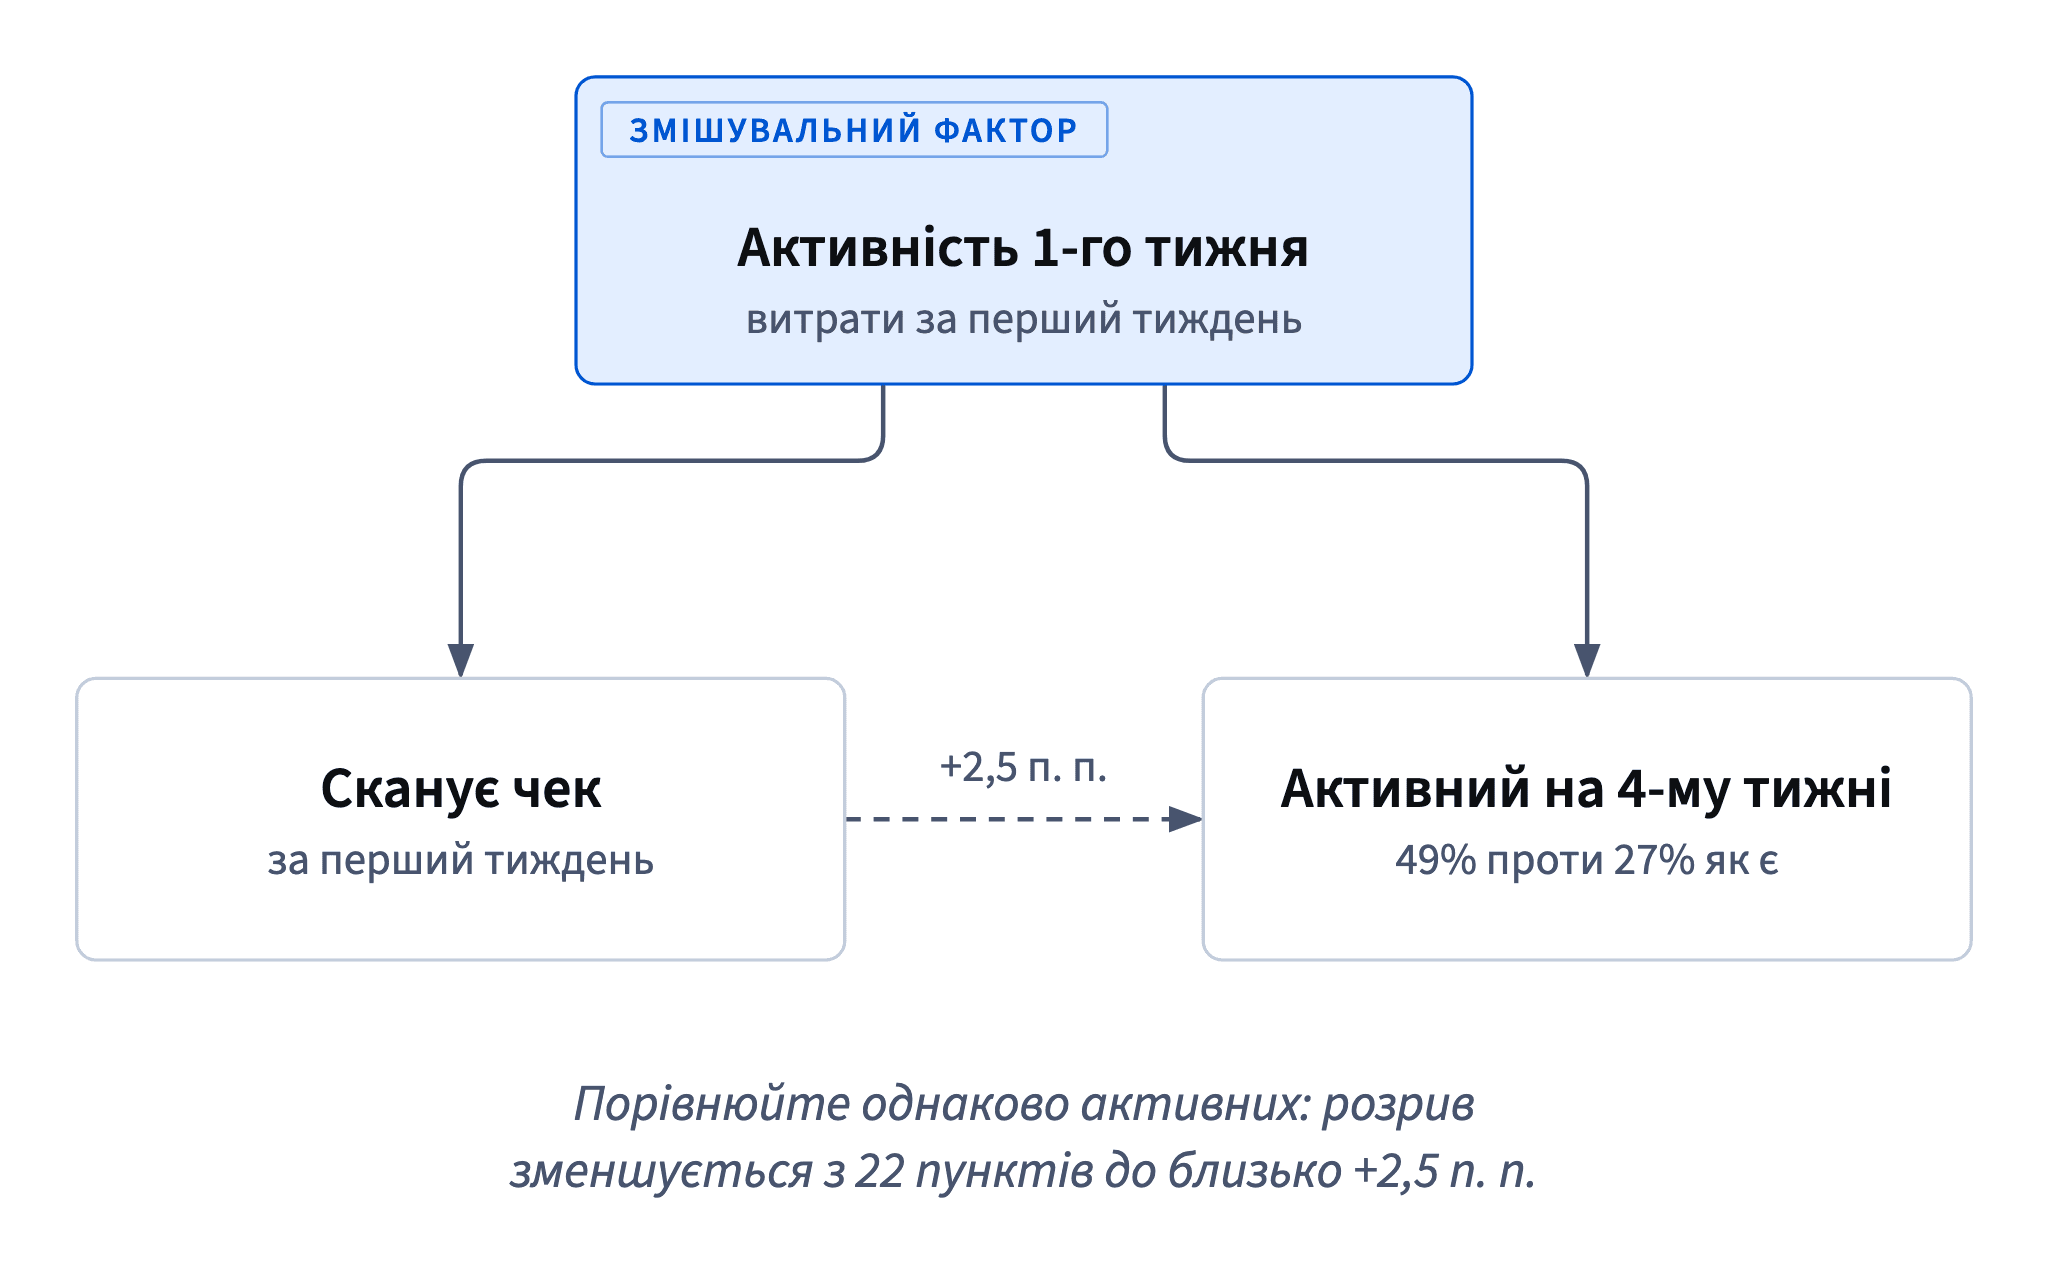
У цьому основна логіка розшарування: якби функція мала велике значення, її розрив зберігся б усередині груп схожих користувачів. Коли розрив обвалюється, початкове порівняння було здебільшого про те, хто ці користувачі.
Дві межі лишаються. Групи грубі, тож якась різниця в активності досі є всередині кожної. І розшаровувати можна лише за тим, що виміряли: усе інше, чим ті, хто сканує, відрізняються від решти, лишається в тих двох-трьох пунктах.
- Так
5_plus: 60,73% − 58,69% = +2,04 п. п. - Не такТі, хто сканував, у
5_plus(60,73%) проти всіх, хто не сканував (27,37%)Порівнює активних з усіма: змішувальний фактор повертається.
Яку частину розриву дає структура? Вирівнюй в обидва боки
Перезважування — той самий інструмент, яким урок Структура трафіку і сезонність міряє зсув структури, — показує й те, яку частину розриву пояснює змішувальний фактор: дай одній групі структуру груп активності іншої, зберігши її власні частки. Так три розриви всередині груп стають одним числом.
Ті, хто сканує, за структурою тих, хто ні. Ті, хто не сканує: 49,61% у 1, 35,72% у 2_to_4 і 14,67% у 5_plus. Підстав частки тих, хто сканує: 0,4961 × 15,79 + 0,3572 × 36,84 + 0,1467 × 60,73 ≈ 29,9% проти 27,4% у тих, хто не сканує: близько +2,5 п. п.
Ті, хто не сканує, за структурою тих, хто сканує. Ті, хто сканує: 11,56%, 26,98% і 61,46%. Підстав частки тих, хто не сканує: 0,1156 × 12,88 + 0,2698 × 34,64 + 0,6146 × 58,69 ≈ 46,9% проти 49,1% у тих, хто сканує: близько +2,2 п. п.
Обидва напрямки розповідають ту саму історію. Дай тим, хто не сканує, активність тих, хто сканує, — і вони підскочать з 27,4% до 46,9%: приблизно 19,5 з 21,7 пункта пояснює сама лише активність. На сканування припадає близько 2–2,5 пункта.
Відповіді трохи різняться, бо трохи різняться розриви в групах; жодна не єдино правильна. Кажи, яку структуру взяли.
- Так0,1156 × 12,88 + 0,2698 × 34,64 + 0,6146 × 58,69 ≈ 46,9%
- Не такЗважити за структурою тих, хто сканує, але з їхніми ж частками → 49,1%
Це просто відтворює частку тих, хто сканує; підставляй частки іншої групи.
Що можуть підтвердити спостережні дані
Після розшарування розклади кожне можливе твердження на дві купки.
Підтверджено (описово):
- нові користувачі, які сканували за перший тиждень, краще утримувалися на четвертому тижні (49% проти 27%);
- більша частина розриву — від того, що ті, хто сканує, активніші на першому тижні;
- серед однаково активних ті, хто сканував, утримувалися на 2–3 пункти краще.
Не підтверджено (причинно чи прогнозно):
- «сканування підвищує утримання приблизно на 22 пункти»: більшу частину розриву дає активність;
- «якщо скануватимуть усі, утримання сягне 49%»: це припускає, що розрив спричинило сканування і що він перейде на тих, хто зараз сканувати не обирає;
- «сканування нічого не дає»: залишкові 2–3 пункти можуть бути, а можуть і не бути від сканування.
Залишковий розрив не можна приписати скануванню, бо порівняння ділили лише за однією ознакою. Ті, хто сканує, можуть бути ще й «скарбниками» групи, більше подорожувати чи мати тріал Plus. Кожне з цього може пояснити кілька пунктів, і жодне не є стовпцем таблиці.
Тож чесний підсумок: «ті, хто сканує, утримуються краще здебільшого тому, що вони активніші», плюс тест для решти.
- Так«Серед однаково активних ті, хто сканував, утримувалися на 2–3 пункти краще.»
- Не так«Нехай усі сканують — і утримання сягне 49%.»
Прогноз щодо втручання, якого дані ніколи не бачили.
Ефект на всіх призначених менший
У рандомізованому тесті ефект на всіх призначених менший, ніж ефект на тих, кого зміна справді зрушила. Це розбавлення, описане в уроці Хто потрапляє в тест: тригери й кластерна рандомізація: зміна зачіпає лише частину аудиторії.
Підказка сканувати не змушує сканувати всіх. Дехто сканував би й так, а багато хто підказку ігнорує. Якщо підказка спонукає сканувати 20% призначених, а сканування справді додало їм 2,5 п. п. утримання на четвертому тижні, то ефект на всіх призначених:
Ефект на всіх призначених = частка зрушених × ефект на зрушених = 0,20 × 2,5 = 0,5 п. п.
Саме порівняння всіх призначених робить тест чесним, тож планувати треба під менше число. Тест, розрахований на +22 пункти зі слайда, був би безнадійно малим для справжнього ефекту в пів пункту. Плануй MDE з реалістичного ланцюжка (скількох користувачів зрушить підказка, помножене на правдоподібний ефект для них), а не зі спостережного розриву.
Порівняння лише тих, хто сканував, у кожному варіанті ефект не рятує; воно повертає зміщення відбору.
- Так0,20 зрушених × 2,5 п. п. = 0,5 п. п. на всіх призначених
- Не такРозрахувати тест підказки на MDE +22 пункти
Спостережний розрив — здебільшого відбір, а підказка зрушує лише частину людей.
Тестуй те, що запустиш, і порівнюй всіх призначених
Справжнє питання команди — не абстрактне «чи допомагає сканування?», а «чи підвищить утримання просування сканування?» Це питання про те, що можна запустити, а отже, його можна протестувати.
Схема:
- Рандомізуй зміну, яку можна запустити, наприклад підказку в онбордингу, що пропонує сканувати. Хто її отримає, вирішує монетка, тож групи схожі в усьому, виміряному чи ні.
- Порівнюй всіх призначених, сканували вони чи ні, за утриманням на четвертому тижні (порівняння за призначенням).
- Розраховуй тест на реалістичний ефект, значно менший за спостережний розрив.
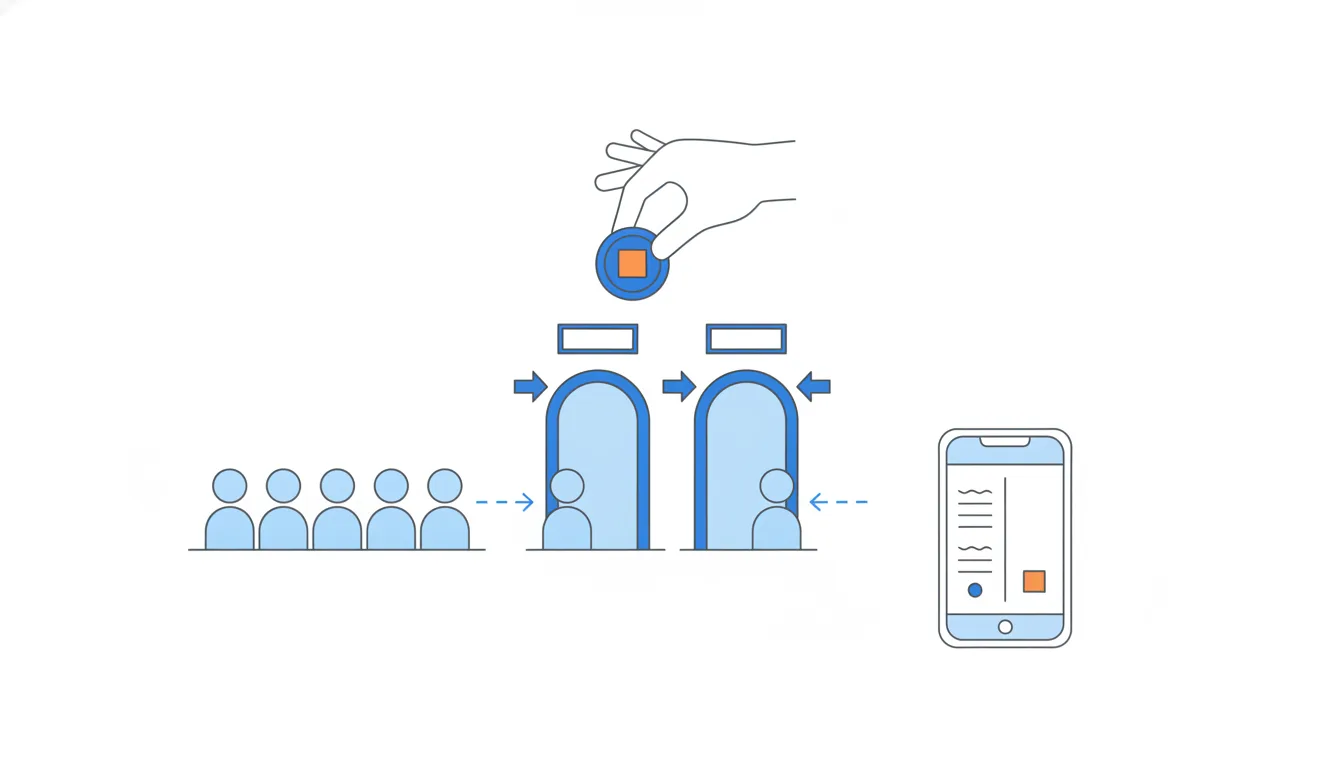
Спокусливі альтернативи зберігають зміщення: порівняння тих, хто сканує, і тих, хто ні, за довший період — те саме самовідібране порівняння; «до і після» змішує підказку з усім іншим; порівняння лише тих, хто сканував, у кожному варіанті знову дає людям відібрати себе самим.
Як це складається докупи: опиши розрив, з'ясуй, хто обрав функцію, порівняй всередині змішувального фактора, перезваж, щоб оцінити його внесок, а тоді тестуй зміну, яку запустиш, за призначенням і на реалістичний ефект. Далі — Кейс: версія чи трафік?, де ці інструменти працюють разом.
- ТакРандомізувати підказку сканувати; порівняти утримання на четвертому тижні всіх призначених і всіх непризначених
- Не такРандомізувати підказку, а потім порівнювати лише тих, хто сканував, у кожному варіанті
Підказка змінює, хто сканує, тож зміщення відбору повертається.
Готові потренуватися?
Виконайте вправи уроку й отримайте 250 балів, коли пройдете його вперше.
Розпочати вправи