

Що означає p-значення: пояснення для продакт-менеджерів
Що означає p-значення (p-value) простими словами: що воно каже про A/B-тест, що таке p < 0,05 і статистична значущість, і чого воно не каже.
Автор: Sergey BruhОпубліковано 7 хв читання
Що означає p-значення (p-value) простими словами: що воно каже про A/B-тест, що таке p < 0,05 і статистична значущість, і чого воно не каже.
Автор: Sergey BruhОпубліковано 7 хв читання
Безкоштовний курс для продактів і маркетологів: короткі уроки, реальні продуктові дані та вправи з миттєвим фідбеком.
Почати безкоштовний курс9 хв читання
Підглядання в A/B-тестах множить хибні перемоги: у 100 000 симульованих A/A-тестів щоденні перевірки дали 27,6 % помилок замість 5 %. Що робити натомість.
9 хв читання
Що показує 95-відсотковий довірчий інтервал в A/B-тесті, як читати інтервал, що містить нуль, і чому для рішення він корисніший за p-значення.
Що означає p-значення (p-value), якщо одним реченням: це ймовірність побачити різницю, не меншу за ту, яку ви отримали, за умови, що насправді жодної різниці немає. Маленьке p-значення (за домовленістю — менше 0,05) означає, що ваш результат був би дивним у світі, де зміна нічого не дала. Отже, є певні підстави вважати, що вона таки щось дала, — саме це і називають статистичною значущістю. Але p-значення не каже, з якою ймовірністю ваш варіант кращий, наскільки великий ефект і чи важливий він для бізнесу. Більшість поганих рішень за підсумками A/B-тестів з'являються тоді, коли від p-значення чекають більшого, ніж воно може дати.
Котокорм, інтернет-магазин кормів для тварин, тестує на сторінці товару банер «Безкоштовна доставка від 30 доларів». Через два тижні:
Варіант конвертує на 0,6 відсоткового пункту краще — це відносний приріст 15 %. Це реальний ефект чи такий розрив міг дати звичайний випадковий шум?
z-критерій для двох часток дає і .
Людською мовою: якби банер не впливав ні на що, розрив у 0,6 пункту або більший (в будь-який бік) траплявся б приблизно в 3,6 % експериментів такого розміру — просто через те, як випадково розподілилися відвідувачі між групами. Це досить малоймовірно, тож у команди є розумні підстави вважати, що банер допомагає.
Будь-яке p-значення отримують за три кроки:
Далі його порівнюють із порогом, обраним до тесту, — рівнем значущості (зазвичай 0,05). Якщо , результат називають статистично значущим.
«, отже, з імовірністю 3,6 % банер нічого не дає» — найпоширеніше хибне тлумачення. p-значення рахують, припустивши, що правдива, тож воно не може водночас казати, наскільки імовірна.
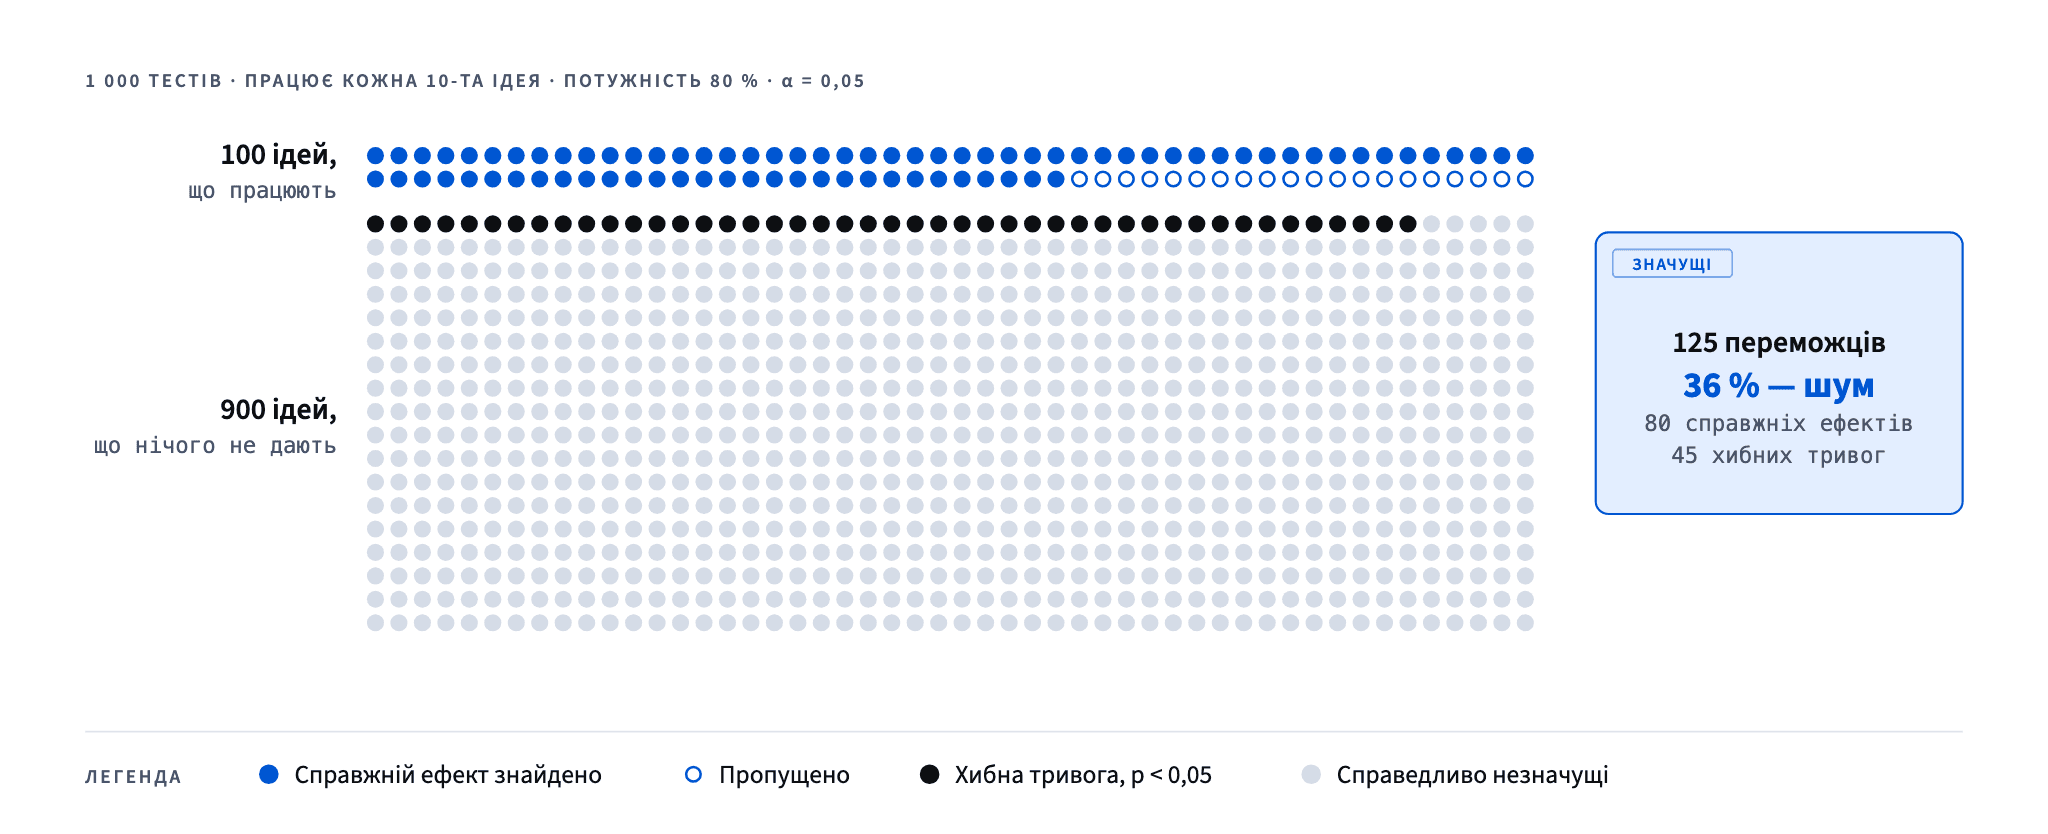
Чому це важливо? Припустімо, що з усіх ідей, які тестує команда, справді працює лише кожна десята, потужність тестів — 80 %, а . Зі 1 000 тестів:
Разом 125 «переможців», і 45 із них хибні: 36 % значущих результатів — це шум, хоча в кожного з них . Саме p-значення не підкаже, які саме.
«З імовірністю 97 % банер виграє» — та сама помилка, тільки навпаки. Такі твердження потребують баєсівського аналізу з явно заданою апріорною ймовірністю. Деякі інструменти для A/B-тестів їх показують, але класичне p-значення — ні.
Крихітний і марний ефект може мати дуже маленьке p-значення, якщо вибірка достатньо велика. За мільйона відвідувачів у кожній групі зміна конверсії з 4,00 % до 4,08 % дає . Результат дуже значущий — і, можливо, не вартий часу розробників на підтримку.
Працює і навпаки. Повернімося до тесту банера, але з 1 000 відвідувачів у групі і тими самими 4,0 % проти 4,6 %: тепер . Ефект точно такий самий, просто тест замалий, щоб відрізнити його від шуму.
не означає «банер не працює». Воно означає «цей тест не зміг розрізнити». Відсутність доказів — не доказ відсутності, особливо коли тест має низьку потужність. Перш ніж поховати ідею, перевірте, чи вистачало користувачів, щоб помітити важливий для вас ефект.
Це два різні питання:
Потрібні обидві. Тому поряд із p-значенням завжди дивіться на розмір ефекту і його довірчий інтервал. Для тесту банера 95-відсотковий довірчий інтервал різниці — приблизно від +0,04 до +1,16 відсоткового пункту. Цей діапазон каже дві речі одночасно: ефект, імовірно, позитивний (інтервал не містить нуля, що узгоджується з ), і він може бути будь-яким — від мізерного до великого. Для рішення це набагато корисніше, ніж «».
Підглядання. Якщо щодня перевіряти результати і зупиняти тест, щойно опуститься нижче 0,05, реальна частка хибнопозитивних результатів помітно перевищує 5 % (докладніше — чому підглядання ламає A/B-тести). p-значення розраховане на один аналіз при запланованому розмірі вибірки.
Багато метрик — один «переможець». Перевірте 10 незалежних метрик без реального ефекту з — і ймовірність, що хоча б одна вийде «значущою», становитиме . Для 20 метрик — близько 64 %. Оберіть одну основну метрику до запуску або застосуйте поправку на множинні порівняння.
Нарізання сегментів постфактум. «Загалом незначуще, зате значуще для користувачів iOS у Києві у вихідні» — майже завжди хибнопозитивний результат. Сегменти, які ви не планували заздалегідь, — це ідеї для наступного тесту, а не висновки.
Вважати 0,049 і 0,051 протилежностями. Межа 0,05 — це домовленість, а не закон природи. Результат із майже такий самий переконливий, як і з .
Стейкхолдерам не потрібне визначення p-значення. Їм потрібно знати, що сталося, наскільки ви впевнені і що пропонуєте. Шаблон, який працює:
Банер підвищив конверсію з 4,0 % до 4,6 % (+0,6 в. п., +15 %). 95-відсотковий довірчий інтервал приросту — від +0,04 до +1,16 в. п., тож ефект майже напевно позитивний, але може бути невеликим. Результат статистично значущий (). Сторінку товару відвідують близько 43 000 людей на місяць, тож за точковою оцінкою це приблизно 250 додаткових замовлень щомісяця; на нижній межі інтервалу виграш був би мінімальним. Рекомендація: запускаємо на всіх і ще чотири тижні стежимо за конверсією та середнім чеком.
Зверніть увагу на структуру: спершу ефект, невизначеність — як діапазон, p-значення — як допоміжна деталь, а рішення прив'язане до впливу на бізнес. Уникайте формулювань «тест довів», «на 97 % упевнені, що банер виграє» і «ефекту немає» для незначущого результату. Натомість кажіть: «ми не змогли виявити ефект, більший за X».
Це означає, що якби зміна не мала реального ефекту, результати, такі ж екстремальні, як ваші, траплялися б менш ніж у 5 % випадків. За домовленістю такий результат називають статистично значущим. Це не означає, що ваша гіпотеза правильна з імовірністю 95 %.
Це слабкий доказ — приблизно такий самий слабкий, як і 0,04. Замість суперечок про поріг подивіться на довірчий інтервал і на ставки для бізнесу. Якщо правдоподібний діапазон містить ефекти, які мали б значення, подумайте про довший або більший тест, а не оголошуйте ні перемогу, ні поразку.
Не зовсім. Інструменти можуть показувати «p = 0,000» або «p < 0,001», коли значення дуже мале. Пишіть «p < 0,001» і пам'ятайте, що на величезних вибірках навіть дрібні ефекти дають мізерні p-значення.
Вони використовують баєсівські методи, які відповідають на інше питання: наскільки ймовірно, що варіант кращий, з огляду на дані й апріорне припущення. Це легше пояснити, але це не те саме число, що p-значення, і воно залежить від налаштувань, які варто розуміти, перш ніж йому довіряти.
Безкоштовний урок p-значення та значущість будує p-значення з нуля на експерименті Котокорму. У ньому є тести саме на ті хибні тлумачення, про які йшлося вище, і практичне завдання з перевіркою ШІ. Це частина безкоштовного курсу «Статистика для продакт-менеджерів і маркетологів».
Щоб перевірити власні числа, скористайтеся безкоштовним калькулятором статистичної значущості: він приймає кількості двох груп і показує p-значення для однобічного чи двобічного тесту, пояснення простими словами і рисунок, де на кривій опинився ваш результат.