

Теорія
Статистична потужність і обсяг вибірки
Статистична потужність і обсяг вибірки: скільки користувачів потрібно експерименту, щоб виявити важливий для тебе ефект.
~9 хв читання · 11 вправ · 250 балів
Перед початком
Чи покажуть це 200 користувачів?
Ти й далі відповідаєш на запитання продуктової команди Котокорму щодо даних, і наступним у черзі — тест редизайну чекауту. План такий: запустити його на 200 користувачів у кожному варіанті й подивитися результат у п'ятницю. Ніхто не спитав, який ефект тест має впіймати і чи покажуть його 200 користувачів, якщо він справжній.
У цьому уроці ти проведеш аналіз потужності: як ще до запуску порахувати, скільки користувачів потрібно експерименту.
Статистична потужність: шанс помітити реальний ефект
Кожен тест може помилитися двома способами. Він може «знайти» ефект, якого немає (помилка першого роду, її контролює α), або пропустити ефект, який є (помилка другого роду, з імовірністю β).
Статистична потужність — протилежний бік β:
потужність = 1 − β
Це ймовірність, що тест дасть значущий результат, коли важливий для тебе ефект справді існує. Звична ціль — 80%: якщо редизайн справді піднімає конверсію на заплановану величину, тест помітить це чотири рази з п'яти, а один раз пропустить.
Чому це важливо продуктовій команді: недостатньо потужний тест зазвичай закінчується «значущої різниці немає». Це читають як «ідея не працює» і відкладають її, хоча тест просто не мав чесного шансу побачити ефект.
Потужність не зчитують після тесту. Її задають заздалегідь, обираючи обсяг вибірки. Цей розрахунок називають аналізом потужності, і саме його будує решта уроку.
- Так«За потужності 80%, якщо приріст справді 1 пункт, ми маємо 20% шансів його пропустити».
- Не так«Потужність — це ймовірність, що наш результат хибнопозитивний».
Це α, помилка першого роду. Потужність стосується пропуску реальних ефектів.
Доданок дисперсії: p(1 − p) для кожної групи
Формула обсягу вибірки для порівняння двох коефіцієнтів конверсії має три складники: критичні значення, різницю, яку хочеш виявити, і те, наскільки шумний результат. Для результату «так / ні» шум — це p(1 − p).
Для базового рівня 5% і цілі 6%:
- 0,05 × 0,95 = 0,0475;
- 0,06 × 0,94 = 0,0564;
- сума = 0,1039.
Ця сума стоїть у чисельнику формули. p(1 − p) найбільше при p = 0,5 (0,25) і меншає до 0 і 1, тож метрика близько 50% шумніша на одного користувача, ніж метрика близько 5%. Проте малі коефіцієнти конверсії все одно дорого тестувати, бо різниці між ними крихітні.
Тримай p десятковим дробом. Запис 5 × 95 + 6 × 94 = 1 039 схожий, але в 10 000 разів більший, і якщо різниця в знаменнику лишилася в десяткових дробах, обсяг вибірки вийде абсурдним. Обери одну одиницю і використовуй її всюди; десяткові дроби — надійніша звичка.
- Так0,05 × 0,95 + 0,06 × 0,94 = 0,0475 + 0,0564 = 0,1039
- Не так0,05 + 0,06 = 0,11
Додає самі коефіцієнти і губить частину (1 − p).
MDE — найсильніший важіль, бо він у квадраті
Мінімальний виявлюваний ефект (MDE) — найменша реальна різниця, яку тест має вміти вловити. Це бізнес-рішення: який приріст вартий запуску?
У формулі обсягу вибірки MDE стоїть у знаменнику в квадраті:
n ≈ (z_α/2 + z_β)² × [p1(1 − p1) + p2(1 − p2)] / (p1 − p2)²
Формула: Приблизний обсяг вибірки на варіант для z-критерію для двох часток при рівні значущості α (двобічний) і потужності 1 − β. · є вище
Тож потрібна вибірка змінюється як 1 / MDE². Зменш MDE удвічі — і знадобиться приблизно вчетверо більше користувачів; утричі — приблизно вдев'ятеро.
За базового рівня 5%, α = 0,05 і потужності 80%:
- виявити 5% → 7% (2 пункти) — приблизно 2 207 користувачів на варіант;
- виявити 5% → 6% (1 пункт) — приблизно 8 146.
Співвідношення не рівно 4, бо доданок дисперсії трохи змінюється з p2, але «удвічі менший MDE — учетверо більше користувачів» — правильна інтуїція.
Саме тому гонитва за крихітними приростами дорога. Перш ніж просити MDE 0,5 пункту, перевір, чи такий малий приріст узагалі змінить рішення.
- ТакMDE 2 в. п. → 1 в. п.: n × (2 / 1)² = n × 4
- Не так«Ефект удвічі менший, отже, користувачів удвічі більше».
Забуває, що MDE у формулі в квадраті.
Аналіз потужності крок за кроком
Розрахунок тесту конверсії — це чотири невеликі обчислення. Візьмімо базовий рівень 10% і ціль 12% при α = 0,05 (двобічний) і потужності 80%:
Формула: Приблизний обсяг вибірки на варіант для z-критерію для двох часток при рівні значущості α (двобічний) і потужності 1 − β. · є вище
- Критичні значення: (1,96 + 0,84)² = 2,8² = 7,84. Ці числа змінюються, лише якщо змінити α чи потужність.
- Доданок дисперсії: 0,10 × 0,90 + 0,12 × 0,88 = 0,09 + 0,1056 = 0,1956.
- Квадрат різниці: (0,12 − 0,10)² = 0,02² = 0,0004.
- Ділення: n ≈ 7,84 × 0,1956 / 0,0004 ≈ 3 834 користувачі на варіант.
Далі подвой для загальної кількості (приблизно 7 668 для двох варіантів) і заокругли вгору: обсяг вибірки — це мінімум, тож 3 833,76 стає 3 834, а не 3 833.
Найчастіше помиляються в знаменнику. Різниця — 0,02, але формулі потрібен її квадрат, 0,0004. Якщо поділити на 0,02, вийде близько 77 користувачів на варіант — тест, який помітить лише величезні ефекти.
Ця формула — наближення для двох часток. Онлайн-калькулятори можуть відрізнятися на кілька відсотків; для планування це нормально.
- Так7,84 × 0,1956 / 0,0004 ≈ 3 834 на варіант
- Не так7,84 × 0,1956 / 0,02 ≈ 77 на варіант
Ділить на різницю замість її квадрата.
Коли трафіку не вистачає
Аналіз потужності часто дає незручне число: 8 146 користувачів на варіант для сторінки, яку відвідують 1 500 разів на тиждень. Є чесні виходи і нечесні.
Чесні кроки змінюють план:
- погодитися на більший MDE. Зобов'язатися ловити лише більший приріст. Оскільки n залежить від 1 / MDE², це дуже допомагає;
- тестувати довше, доки не набереться вибірка, і заздалегідь сказати, скільки це триватиме;
- тестувати там, де трафік: на жвавішій сторінці чи кроці воронки;
- зменшити шум у метриці, наприклад відсіяти трафік ботів.
Нечесні кроки ховають проблему:
- запустити на фіксоване коротке вікно й повідомити, що вийде;
- послабити α, щоб калькулятор «погодився». При α = 0,10 вибірка меншає приблизно на п'яту (до близько 6 416), але частка хибнопозитивних результатів подвоюється;
- додати метрик, щоб «щось» стало значущим.
Якщо чесного варіанта немає, чесна відповідь — не запускати цей тест зараз або запустити й назвати результат орієнтовним, а не підставою для рішення.
- Так«З нашим трафіком за чотири тижні ми надійно виявимо приріст на 2 пункти, а не на 1. Чи варто тестувати на 2 пункти?»
- Не так«Візьмімо α = 0,10, щоб обсяг вибірки вклався в наші два тижні».
Купує менший n ціною вдвічі більшої кількості хибнопозитивних результатів.
Від обсягу вибірки до календаря
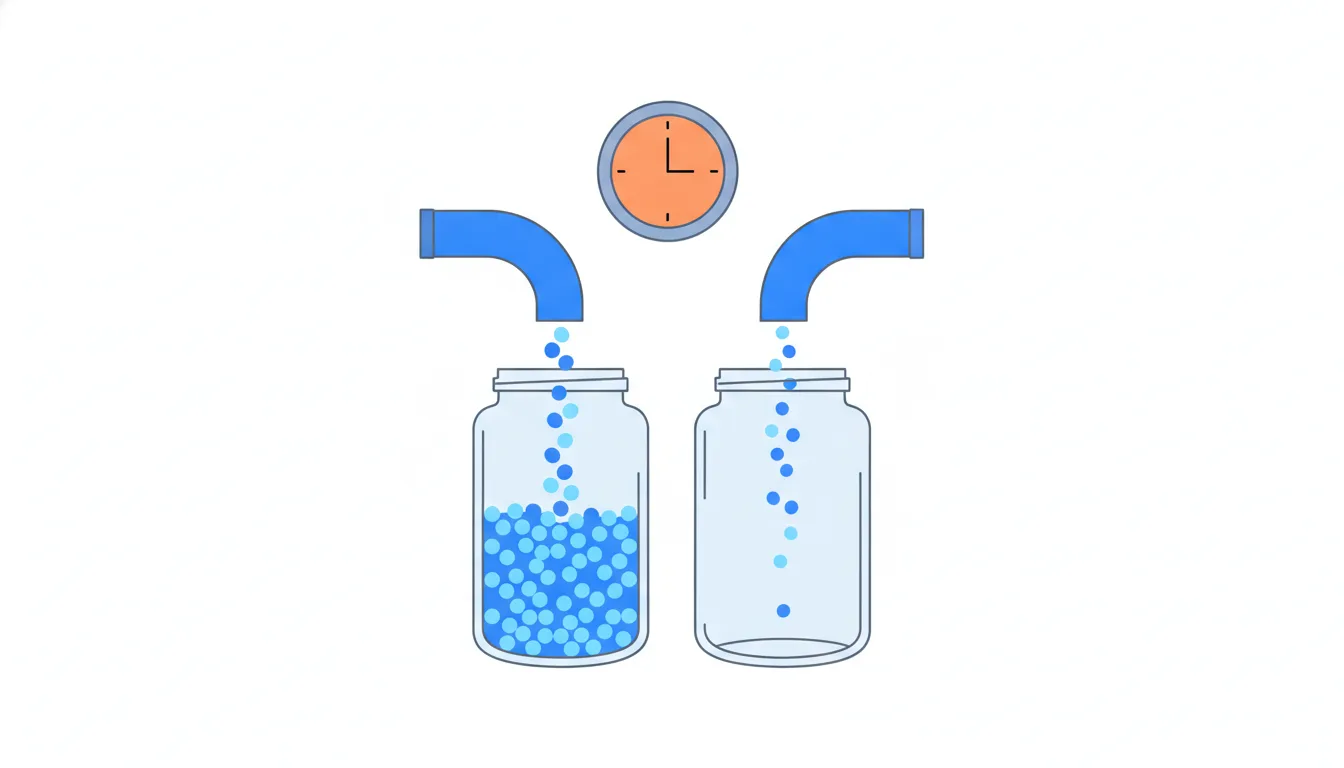
Стейкхолдери мислять не користувачами на варіант, а тижнями. Перерахунок простий:
тривалість = (користувачі на варіант × кількість варіантів) / придатні користувачі на тиждень
Для тесту форми підписки на розсилку Котокорму, якому потрібно 3 834 користувачі на варіант: 3 834 × 2 = 7 668 користувачів. За 1 200 відвідувачів на тиждень це 7 668 / 1 200 ≈ 6,39 тижня.
Два правила заокруглення:
- угору, бо обсяг вибірки — це мінімум;
- до повних тижнів. Поведінка в понеділок — не те саме, що в суботу, тож тест, зупинений посеред тижня, перебільшує вагу частини днів. 6,39 стає 7 тижнями.
Рахуй лише трафік, який справді доходить до тестованого елемента: якщо зміна на кроці оплати, перегляди головної сторінки не допоможуть.
Класична помилка — забути про другу групу: 3 834 / 1 200 ≈ 3,2 тижня виглядає вдвічі швидше, але кожен варіант отримує лише половину трафіку. А якщо чесна відповідь — багато місяців, повертайся до MDE, а не зупиняй тест раніше.
- Так3 834 × 2 / 1 200 = 6,39 → 7 повних тижнів
- Не так3 834 / 1 200 ≈ 3,2 → «чотирьох тижнів вистачить»
Забуває, що трафік ділиться між двома варіантами.
Чотири слова для планування тесту
Спланувати тест — значить вирішити, як часто допустимо помилятися в кожен бік. Цю роботу виконують чотири терміни:
- помилка першого роду (α): відхиляєш істинну нульову гіпотезу. Хибнопозитивний результат: запускаєш банер, який нічого не дає. α = 0,05 означає, що за відсутності ефекту це трапляється в 5% випадків;
- помилка другого роду (β): не відхиляєш хибну нульову гіпотезу. Хибнонегативний результат: відмовляєшся від зміни, яка справді працює;
- статистична потужність (1 − β): шанс правильно виявити реальний ефект запланованого розміру. Звична ціль — 80%;
- мінімальний виявлюваний ефект (MDE): найменша реальна різниця, на виявлення якої розрахований тест.
α і потужність — ймовірності; MDE — розмір. Їх пов'язує обсяг вибірки: коли зафіксовано будь-які два, зібрані дані визначають, наскільки добрим може бути третій.
Підказка для пам'яті: перший рід — кричати «вовк!», коли вовка немає; другий рід — не помітити вовка, який справді є.
- Так«α = 0,05, потужність 80%, MDE 1 пункт: 8 146 користувачів на варіант».
Усі три рішення названо до старту тесту.
- Не так«Тест мав потужність 95%, бо p = 0,05».
Плутає p-значення, α і потужність.
Що збільшує і що зменшує обсяг вибірки
Кожен вибір в аналізі потужності має ціну в користувачах. Почнімо з 8 146 на варіант (5% → 6%, α = 0,05, потужність 80%):
- менший MDE: найсильніший вплив, бо він у квадраті. 5% → 5,5% потребує приблизно вчетверо більше користувачів;
- вища потужність: перехід від 80% до 95% замінює z_β = 0,84 на 1,645, тож (1,96 + 1,645)² ≈ 13,0 замість 7,84, приблизно 13 503 на варіант;
- суворіший α: α = 0,01 використовує 2,576 замість 1,96, тож (2,576 + 0,84)² ≈ 11,67, приблизно 12 124 на варіант;
- шумніший результат: базовий рівень ближче до 50% має більше p(1 − p) на користувача.
Зворотні кроки (більший MDE, нижча потужність, м'якший α) зменшують вибірку, і кожен має ціну: пропускаєш менші ефекти, частіше пропускаєш реальні ефекти або отримуєш більше хибнопозитивних результатів.
Тож розмова зі стейкхолдерами — це компроміс, а не налаштування калькулятора. Виріши, з яким ризиком бізнес може жити, а обсяг вибірки випливе з цього.
- ТакПотужність 95% замість 80%: (1,96 + 1,645)² / (1,96 + 0,84)² ≈ 13,0 / 7,84 ≈ 1,66 раза більше користувачів.
- Не так«Більший MDE потребує більшої вибірки, бо ми виявляємо більше».
Більші ефекти легше виявити, тож їм потрібно менше користувачів.
«Незначущо» не означає «ефекту немає»
p-значення понад 0,05 каже одне: ці дані не дали сильних доказів різниці. Чи це інформативно, залежить від потужності.
- У достатньо потужному тесті (запланована вибірка набрана) незначущий результат корисний: якби ефект розміром із MDE існував, його, найімовірніше, було б видно. Можна сказати: «ефект, якщо він є, найімовірніше менший за MDE».
- У недостатньо потужному тесті те саме p-значення не каже майже нічого. З приблизно 1 500 користувачами на варіант замість 8 146 реальний приріст на 1 пункт зазвичай виходить незначущим. Пропуск був очікуваним результатом.
Тож перш ніж писати «редизайн не працює», перевір, що тест міг виявити. Допомагає довірчий інтервал для різниці: якщо він від −1 до +2 пунктів, виграш на 1 пункт цілком правдоподібний.
Практичне правило: незначущі результати малих тестів подавай як непереконливі, показуй інтервал і вирішуй, чи варто провести тест належного обсягу. Відмова від ідеї через «ні» слабкого тесту — це шлях, яким тихо гинуть добрі зміни.
- Так«p = 0,41 при п’ятій частині запланованої вибірки: результат непереконливий. Приріст на 1 пункт досі правдоподібний».
- Не так«Тест довів, що редизайн не має ефекту».
Недостатньо потужний тест не може довести відсутність ефекту.
Готові потренуватися?
Виконайте вправи уроку й отримайте 250 балів, коли пройдете його вперше.
Розпочати вправи